LLaVA
把视觉表示接入 LLM,再用纯文本大模型构造视觉对话数据
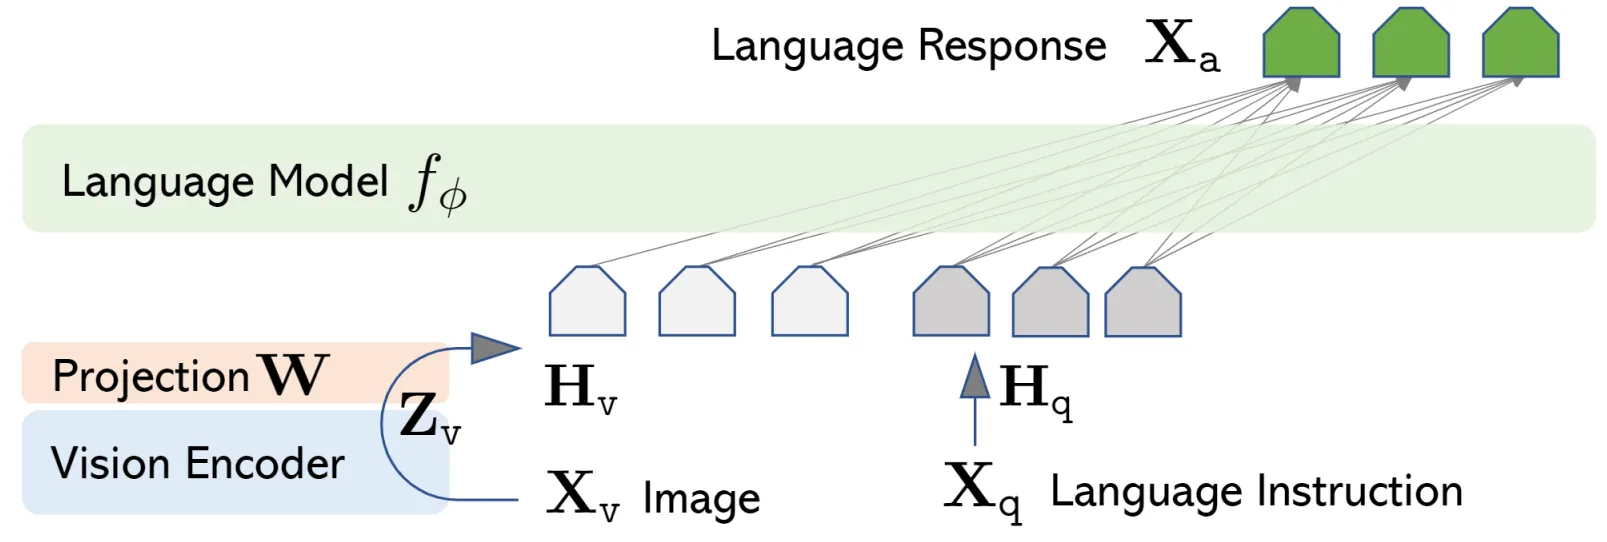
From Visual Instruction Tuning ↗ and Improved Baselines with Visual Instruction Tuning ↗. 封面为初版论文 Figure 1,来自 LLaVA 项目页 ↗,保留原图。
卖点:具备视觉理解能力的连续对话模型。
CLIP 已经可以对齐图像和文本,但它的训练目标是匹配,不是 GPT 式的文本生成,因此本身无法进行开放式对话。
想要做出既有 LLM 生成能力、又能看图的模型,除了把两者接起来,还需要图片与指令、回答对应的数据。而现成的多模态指令数据并不充足,人工构造也比较麻烦。
LLaVA 的一个关键想法是:利用已有的图像标注,让纯文本大模型来构造视觉对话数据。
让纯文本模型「看图写话」#
纯文本模型当然看不到图片,但可以读懂关于图片的文字和结构化描述。
因此,作者将 COCO 图片对应的 captions、目标类别和 bounding boxes 等信息,作为文本输入给 GPT-4,让它生成与图片相关的对话、详细描述和复杂推理问答。
这里的图片并没有输入 GPT-4,它看到的只是图片的「文字替身」。之后训练 LLaVA 时,才把原图片与生成的指令、回答配成样本。
这个思路很妙:已有图文和检测标注本来不是对话数据,但借助 LLM 的语言组织和常识能力,可以把它们转换成更丰富的 instruction-following 数据。
架构#
初版使用预训练好的 CLIP ViT-L/14 作为 image encoder,提取 patch 级别的视觉特征,再用一个投影矩阵,把视觉特征映射到与 LLM 的 word embedding 相同的维度。
得到的 visual tokens 直接和文本 token embeddings 拼到同一个序列里,交给 Vicuna 处理,再自回归地生成回答。
这里不是把图片先翻译成几个词,也没有要求视觉 token 对应词表中的某个 token。只是把连续的视觉表示接入语言模型,让后者学会使用这些表示。
初版的连接器很简单,就是一个线性层;LLaVA-1.5 则换成了两层 MLP,并结合更高输入分辨率的 CLIP encoder 和更多面向具体任务的 VQA 数据等改动,得到更强的 baseline。
训练#
初版分成两个阶段:
- 特征对齐:冻结 image encoder 和 LLM,只训练投影层。先让视觉表示变成语言模型能够利用的输入。
- 视觉指令微调:继续冻结 image encoder,同时训练投影层和 LLM,让模型学会根据图片和指令回答问题、进行对话。
也就是说,「冻结视觉编码器」贯穿这两个阶段,但 LLM 并不是从头到尾都参与训练。
第二阶段仍然采用自回归的文本生成目标,只在 assistant 的回答 token 上计算损失。图片和用户指令作为条件,不要求模型把它们也复述一遍。
局限性与一些想法#
个人首先想到的问题是:这种做法会不会导致幻觉叠加?
纯文本大模型只能根据 captions 和 boxes 猜测场景,可能补出原图中并不存在的细节。再把这些内容当成监督信号训练 LLaVA,确实值得担心。
不过,Improved Baselines with Visual Instruction Tuning 中的讨论提示,幻觉也可能和模型「看不清」有关:当训练答案要求描述的细节超出视觉输入能够分辨的程度,模型就容易学着补全;作者观察到,提高输入分辨率可以明显减轻这种现象。
因此,需要同时考虑标注是否可靠,以及视觉表示是否足以支持回答的细节。让答案更详细,并不自动意味着监督信号更好。
我还会想,能不能再接一个类似 MAE 的 decoder,通过图像重建损失补充视觉约束?或者引入 RL、self-training,让回答更贴近实际图像?
这些暂时只是想法。尤其是重建损失,它鼓励保留图像信息,但不直接保证语言回答中的每个事实都有视觉依据;是否能减轻幻觉,还需要单独设计实验验证。