CLIP
用对比学习对齐图像和文本,再用自然语言构造 zero-shot 分类器
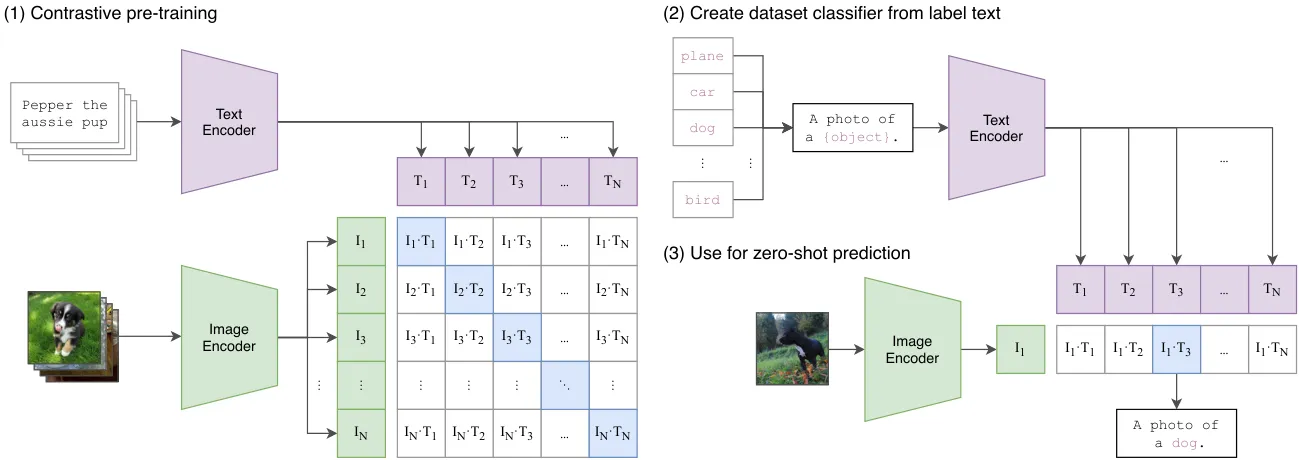
From Learning Transferable Visual Models From Natural Language Supervision ↗. 封面为原论文 Figure 1,保留原图。代码可见 CLIP 仓库 ↗。
OpenAI 的工作,多模态对比学习,效果极好。
与 GPT 系列的生成式训练不同,CLIP 让 text encoder 和 image encoder 各自产生一个表示,然后学习让对应的图文匹配。模型不需要生成句子,只需要判断「这张图和哪段话更相近」。
架构#
双塔结构,两个编码器,分别获得图片和文字的表示,再通过线性投影映射到同一个 embedding space。
Text encoder 是带 causal mask 的 Transformer,取 [EOS] 对应的输出,经过 LayerNorm 和线性投影,作为整段文本的表示。虽然这里把它叫作 encoder,但它并不是 BERT 式的双向注意力模型。
Image encoder 则分别尝试了修改过的 ResNet 和 ViT。ViT 版本总体沿用原架构,在 patch embedding 与 position embedding 相加后额外加入了 LayerNorm 等少量改动。
训练时#
一个 batch 中有 对图文,分别得到归一化后的图像表示 和文本表示 。两两计算相似度,得到一个 的矩阵:
其中 是可学习的对数尺度参数,用来控制 softmax 前的分数尺度。
矩阵的对角线是数据中实际配对的图文,作为正样本;其余配对作为负样本。然后沿两个方向分别计算交叉熵:
- 固定一张图,在 batch 的所有文本中找与之配对的文本。
- 固定一段文本,在 batch 的所有图像中找与之配对的图像。
最后取两者的平均作为损失。
我理解,这相当于让两个 encoder 双向奔赴:我们不规定它们必须输出什么特征,只要求匹配的图文在表示空间里靠近,不匹配的图文远离。
当然,「不匹配」只是 batch 中的配对关系,不代表两者语义上一定无关。CLIP 使用的是网络图文对提供的自然语言监督,也不能简单理解成完全没有监督信息。
预测时#
Prompt Engineering#
将模型用于分类任务时,先准备好类别名称,再依次套入 a photo of a {label}. 这样的 prompt 模板,交给 text encoder 生成对应的表示。
待预测图片通过 image encoder 得到表示,然后与各类别的文本表示计算相似度,选择最大的一个。分类器的「类别权重」就这样由自然语言生成了,不需要再针对这个分类数据集训练一个分类头。
Prompt 还可以加入修饰语,以适配不同的下游任务。比如宠物分类可以写成 a photo of a {label}, a type of pet.,帮助模型理解类别名的含义,而不是只看到一个可能有歧义的词。
Prompt Ensemble#
同一类别可以使用多个不同的 prompt 模板,再综合它们的表示。
具体做法是,先归一化各模板得到的文本表示,对同一类别取平均,再归一化一次,作为该类别最终的表示。这样只需预先算好每个类别的向量,预测时的计算量和单模板基本相同。
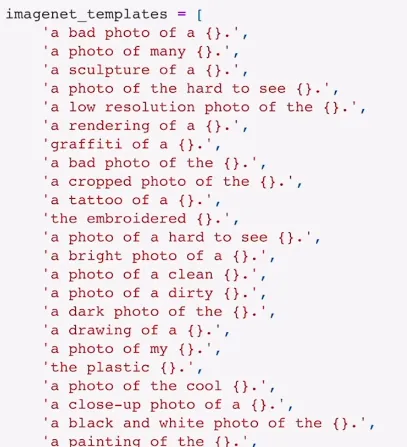
这里平均的是 embedding,而不是每个 prompt 输出的分类概率。具体模板和实现可参考仓库里的 Prompt Engineering for ImageNet ↗。
下面是其中一部分模板,截图里的 {} 用于填入类别名称:
一些想法#
CLIP 中很有意思的一点是,图文对齐训练得到的 image encoder,单独拿出来也具有很好的特征提取能力。冻结它,再接一个线性分类器做 linear probe,同样能在许多下游数据集上获得不错的结果。
这说明,自然语言不只是附在图片旁边的一段说明,也可以成为训练视觉表示的监督信号。不过,它是否优于有监督分类或纯图像自监督方法,仍然需要结合数据规模、模型和具体任务比较,不能一概而论。
另外,CLIP 为两种模态分别使用两个 encoder。个人会想,如果用一个共享的 Transformer 来处理不同模态,也许能让参数共享得更充分?但这也可能让两种模态互相干扰,效果是否更好,仍需要实验。
双塔本身也有很直接的优势:图片和文本都可以独立编码、缓存,匹配时只需要计算向量相似度。