ViT
把图像切成 patch,尽量少改 Transformer:ViT 的架构与归纳偏置
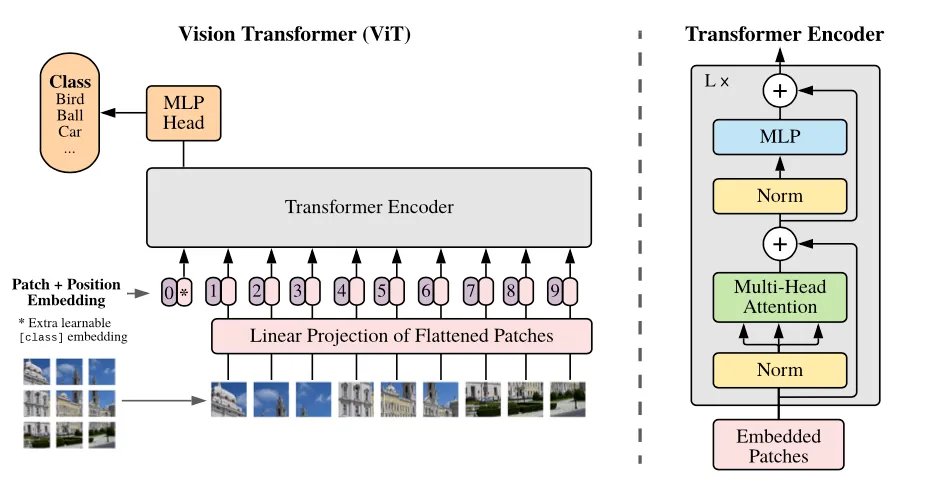
By Google Brain. From An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale ↗. 封面为原论文 Figure 1,来自 ViT 仓库 ↗,保留原图。
将 NLP 中所向披靡的 Transformer 应用于 CV 的一次尝试,并非首次,但证明了:只需很少的图像专用改动,配合大规模预训练,也能取得极好的效果。
秉持着「能不改就不改」的原则,ViT 舍弃了 CNN 中很大一部分图像专用的 Inductive Bias。
架构#
- 将图像切成固定大小、互不重叠的 patch,而不是用滑动窗口逐像素处理。
- 将每个 patch 展平,通过一个共享的、可学习的线性投影,得到 patch embedding。
- 在序列开头添加一个可学习的
[CLS]token embedding,类似 BERT。 - 为整个序列加上可学习的位置编码。
- 经过 Transformer encoder,取
[CLS]对应的输出,接入分类头。
这里的 patch embedding 和文本 embedding 在用途上相似,都是将输入转换成 Transformer 使用的表示;不过图片 patch 是连续的像素向量,使用的是线性投影,并不是拿一个离散 token ID 去查表。
例如,一张 的 RGB 图片,切成 的 patch,会得到 个 patch。每个 patch 展平后有 个数,投影到 hidden dimension,再加上 [CLS],就得到长度为 197 的输入序列。
一些细节#
作者比较了不同位置编码,发现可学习的 1D 编码与更显式的 2D 编码之间,性能没有显著差别。模型可以从数据中学习 patch 之间的空间关系,不一定要把二维结构完全手工写进编码里。
此外,[CLS] 也不是唯一选择。作者尝试过去除它,对 patch 的输出做 global average pooling,再接分类器。调整到合适的学习率之后,两种做法表现相近。
所以,「用一个特殊 token 汇总全图信息」是可行的设计,并不是图像分类一定需要的结构。
一些想法#
我觉得 ViT 的精髓在于,它没有为了适配图像,把 Transformer 改得面目全非。将图像转换成 token 序列之后,就尽量沿用已经在 NLP 中验证过的架构。
但减少归纳偏置也有代价:局部性、二维邻域结构等知识,不再像 CNN 那样被大量写进网络,需要更多地从数据中学习。原论文中,大规模预训练是 ViT 获得强效果的重要条件。
因此,ViT 更让我在意的问题是:有多少东西必须写进架构,又有多少可以交给数据来教会模型?