高效视频理解调研 · 空间自适应感知 #1
每当你想到一个新 idea,就去读下一篇论文吧,然后你会发现它们与你的思路完美契合(撞车)。。。
— views
|
—
comments
由于高帧率视频往往帧间冗余性强,画面运动连续,因此每次采样都取完整画面显得有些浪费。
此外,全画幅采样意味着采样帧率通常较低,典型值为 0.5 ~ 2 fps,这导致不少短暂、精细的动作被截断或忽略。
于是,参考人类视觉机制,一个启发式的想法是:让模型每一帧只观察一小块区域,通过不同帧的观察区域互补来逐渐构建视频理解。并且进一步地,可以考虑在视频帧进入 visual encoder 之前就筛选出有意义的观察区域,将算力分配到更有用的画面上。
这种方法有望维持实时响应的同时提高输入帧率,但它的实际效果需要实验检验。
下面的工作沿着这个方向进行了探索。
01 · GliTr#
PAPER NOTE · 2023
GliTr: Glimpse Transformers with Spatiotemporal Consistency for Online Action Prediction
facebookresearch(FAIR) 恐怖如斯,除这篇外,JEPA DETR DINO MAE DEiT XCiT DiT 也都是他们的工作。
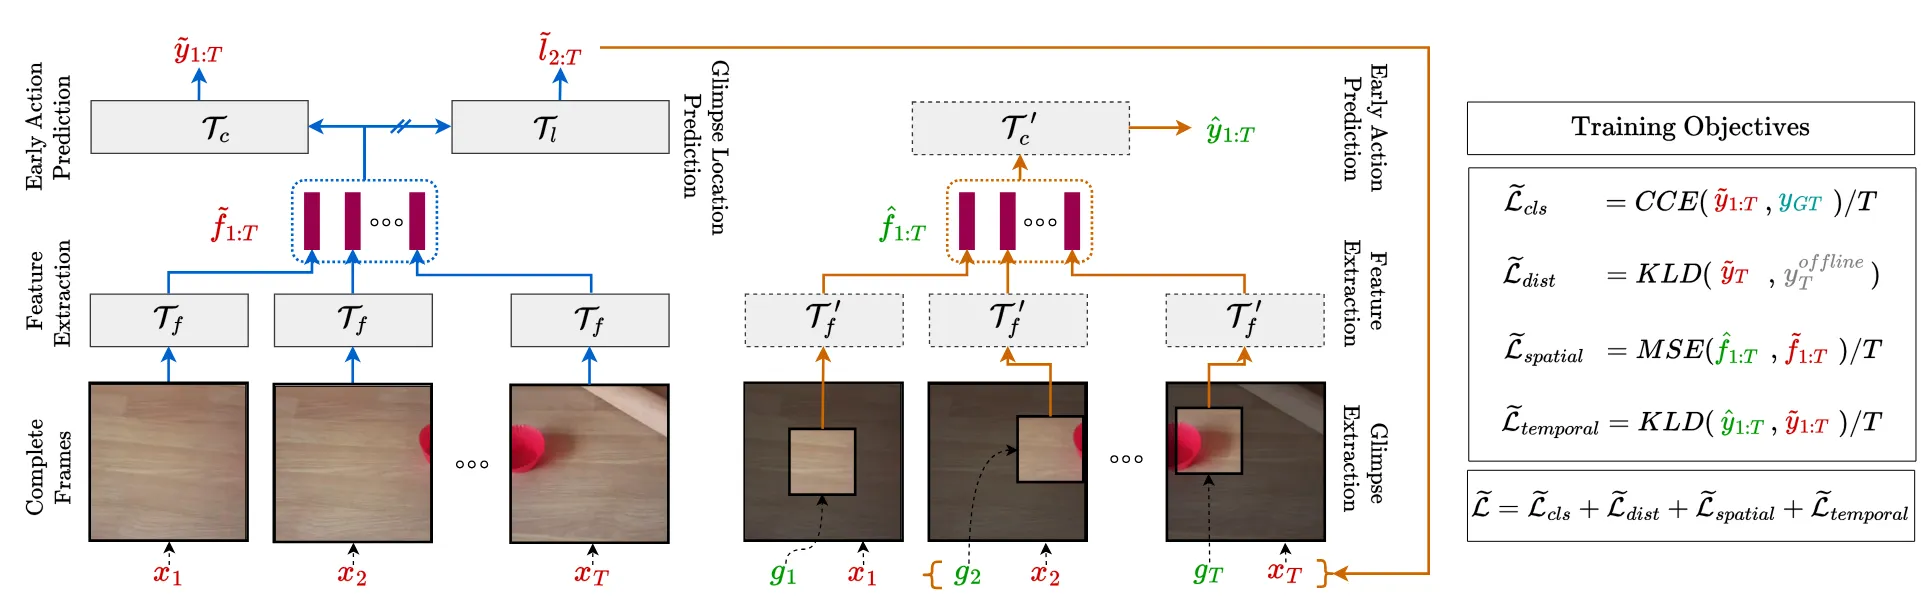
- 问题与动机: 在计算资源受限的情况下,如何降低计算开支同时尽可能保留模型的画面理解能力
- 关键机制:
- 通过裁剪画面,每次仅输入画面的一个局部窗口
- 训练模型自主控制下一次想要观察的窗口的位置
- 训练模型仅通过窗口内容,输出正确的分类标签
- 由于缺少最佳窗口位置的标注,GliTr 采用教师–学生训练范式。教师通过分类监督和离线模型蒸馏,学习从完整帧提取表示并预测动作类别;同时额外训练窗口预测模块,通过最小化时空一致性损失,学习定位有用区域;
学生以教师参数初始化,仅根据已观察到的局部窗口预测动作类别和下一窗口位置,并通过空间一致性对齐教师的整帧特征、通过时间一致性对齐教师截至当前的类别分布。注意,此处并没有直接拟合教师预测的窗口坐标。
- 实验与证据:
- 准确率:局部区域越大,效果越好
- 与其他方法相比:性能稍差或者持平,但计算量降低 74% 以上
- 我的思考:
- GliTr 假设观察窗口是正方形的,模型只需要回归窗口中心坐标。如果允许异形窗口,模型需要回归的变量会变多,对应性能会不会增加?如果让模型在画面上预测一个 attention_mask,取 top-K 的 patches 作为下一次的 glimpse,是否可行?
- 为了使梯度能反传到窗口坐标,GliTr 通过双线性插值采样窗口画面,但坐标梯度只依赖采样点邻域,不能直接指示远处未观测目标的方向。比如,如果一只猫在当前窗口外很远处,那么仅靠窗口的双线性插值,无法产生一个指向猫的梯度。
02 · K-centered Patch Sampling#
PAPER NOTE · 2022
K-centered Patch Sampling for Efficient Video Recognition
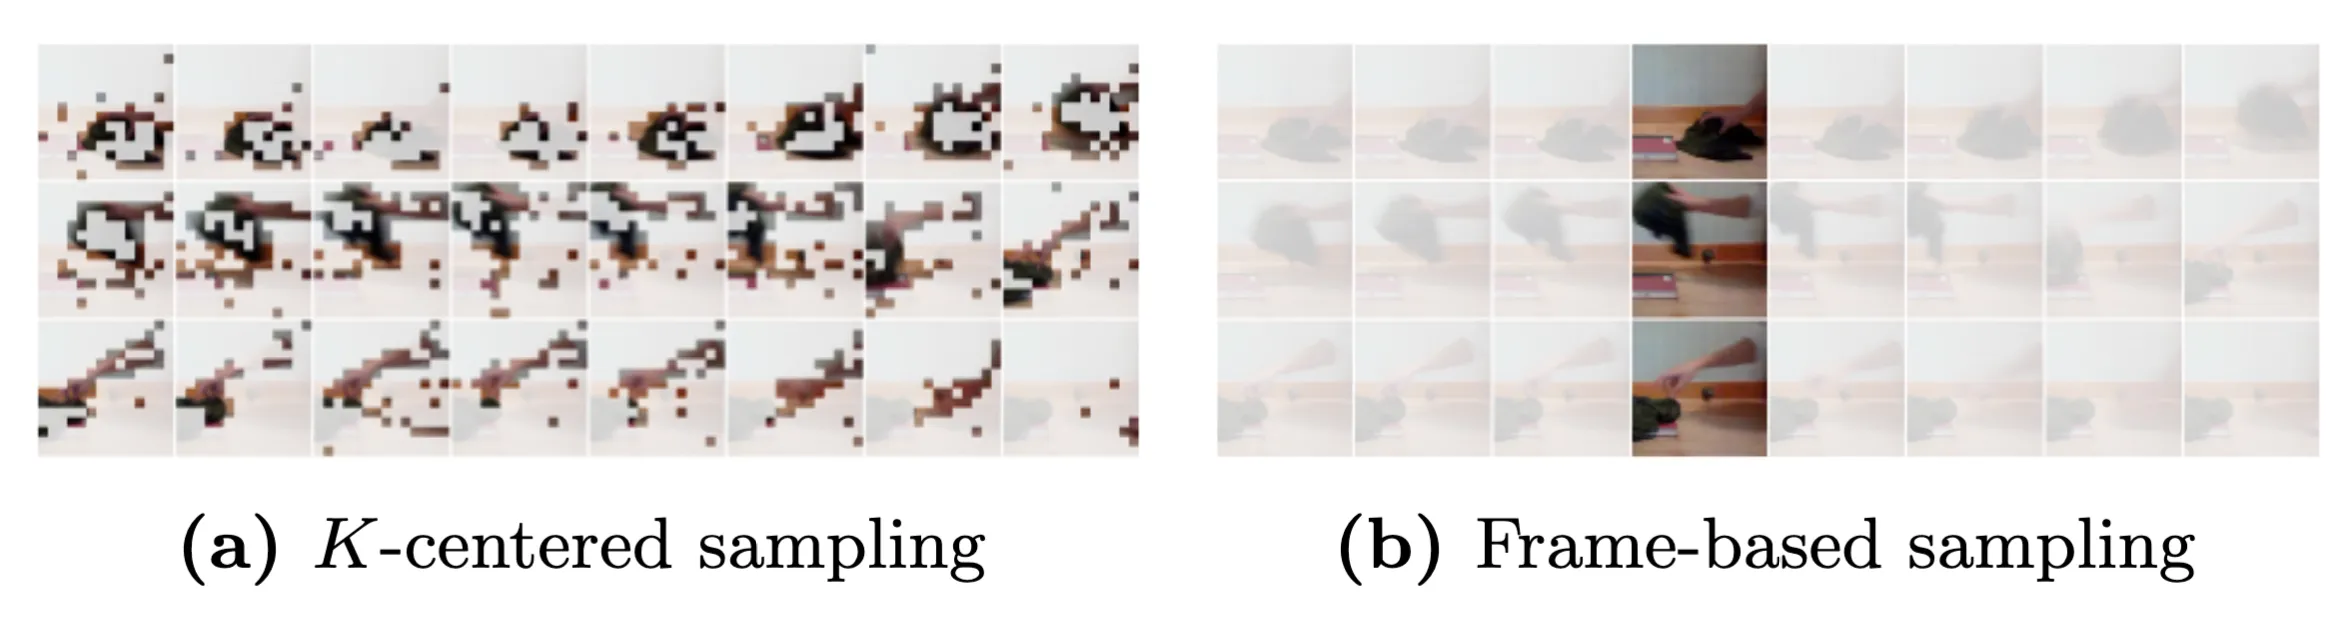
- 问题与动机: 传统视频理解方法是以完整帧为单位进行采样的,这种方式适应 CNN 的处理机制,即对画面尺寸、形状有严格要求。然而,将 ViT 应用于视频处理时,这种方式的弊端显现出来——Transformer 的平方级复杂度致使它处理完整帧的成本较高,从而要求在时间上进行降采样,影响时域信息完整性。此外,ViT 工作在 patches 上而非 feature maps,因此没必要总是输入完整帧。
结合这两个思考,作者提出基于 patch 的降采样方案,使得时域上更多帧能够参与提供信息,同时每帧的冗余信息减少。 - 关键机制: 使用 K-centered 算法从一帧中采样 patches,从而避免输入完整帧画面,减少了信息冗余,但仍保留较全面多样的信息覆盖。
具体地,原文将每个 patch 的所有像素的所有通道展平为一个向量,对通道进行归一化,再 concat 上人为设计好的时空位置编码,然后直接进行基于欧氏距离的 K-centered 采样。
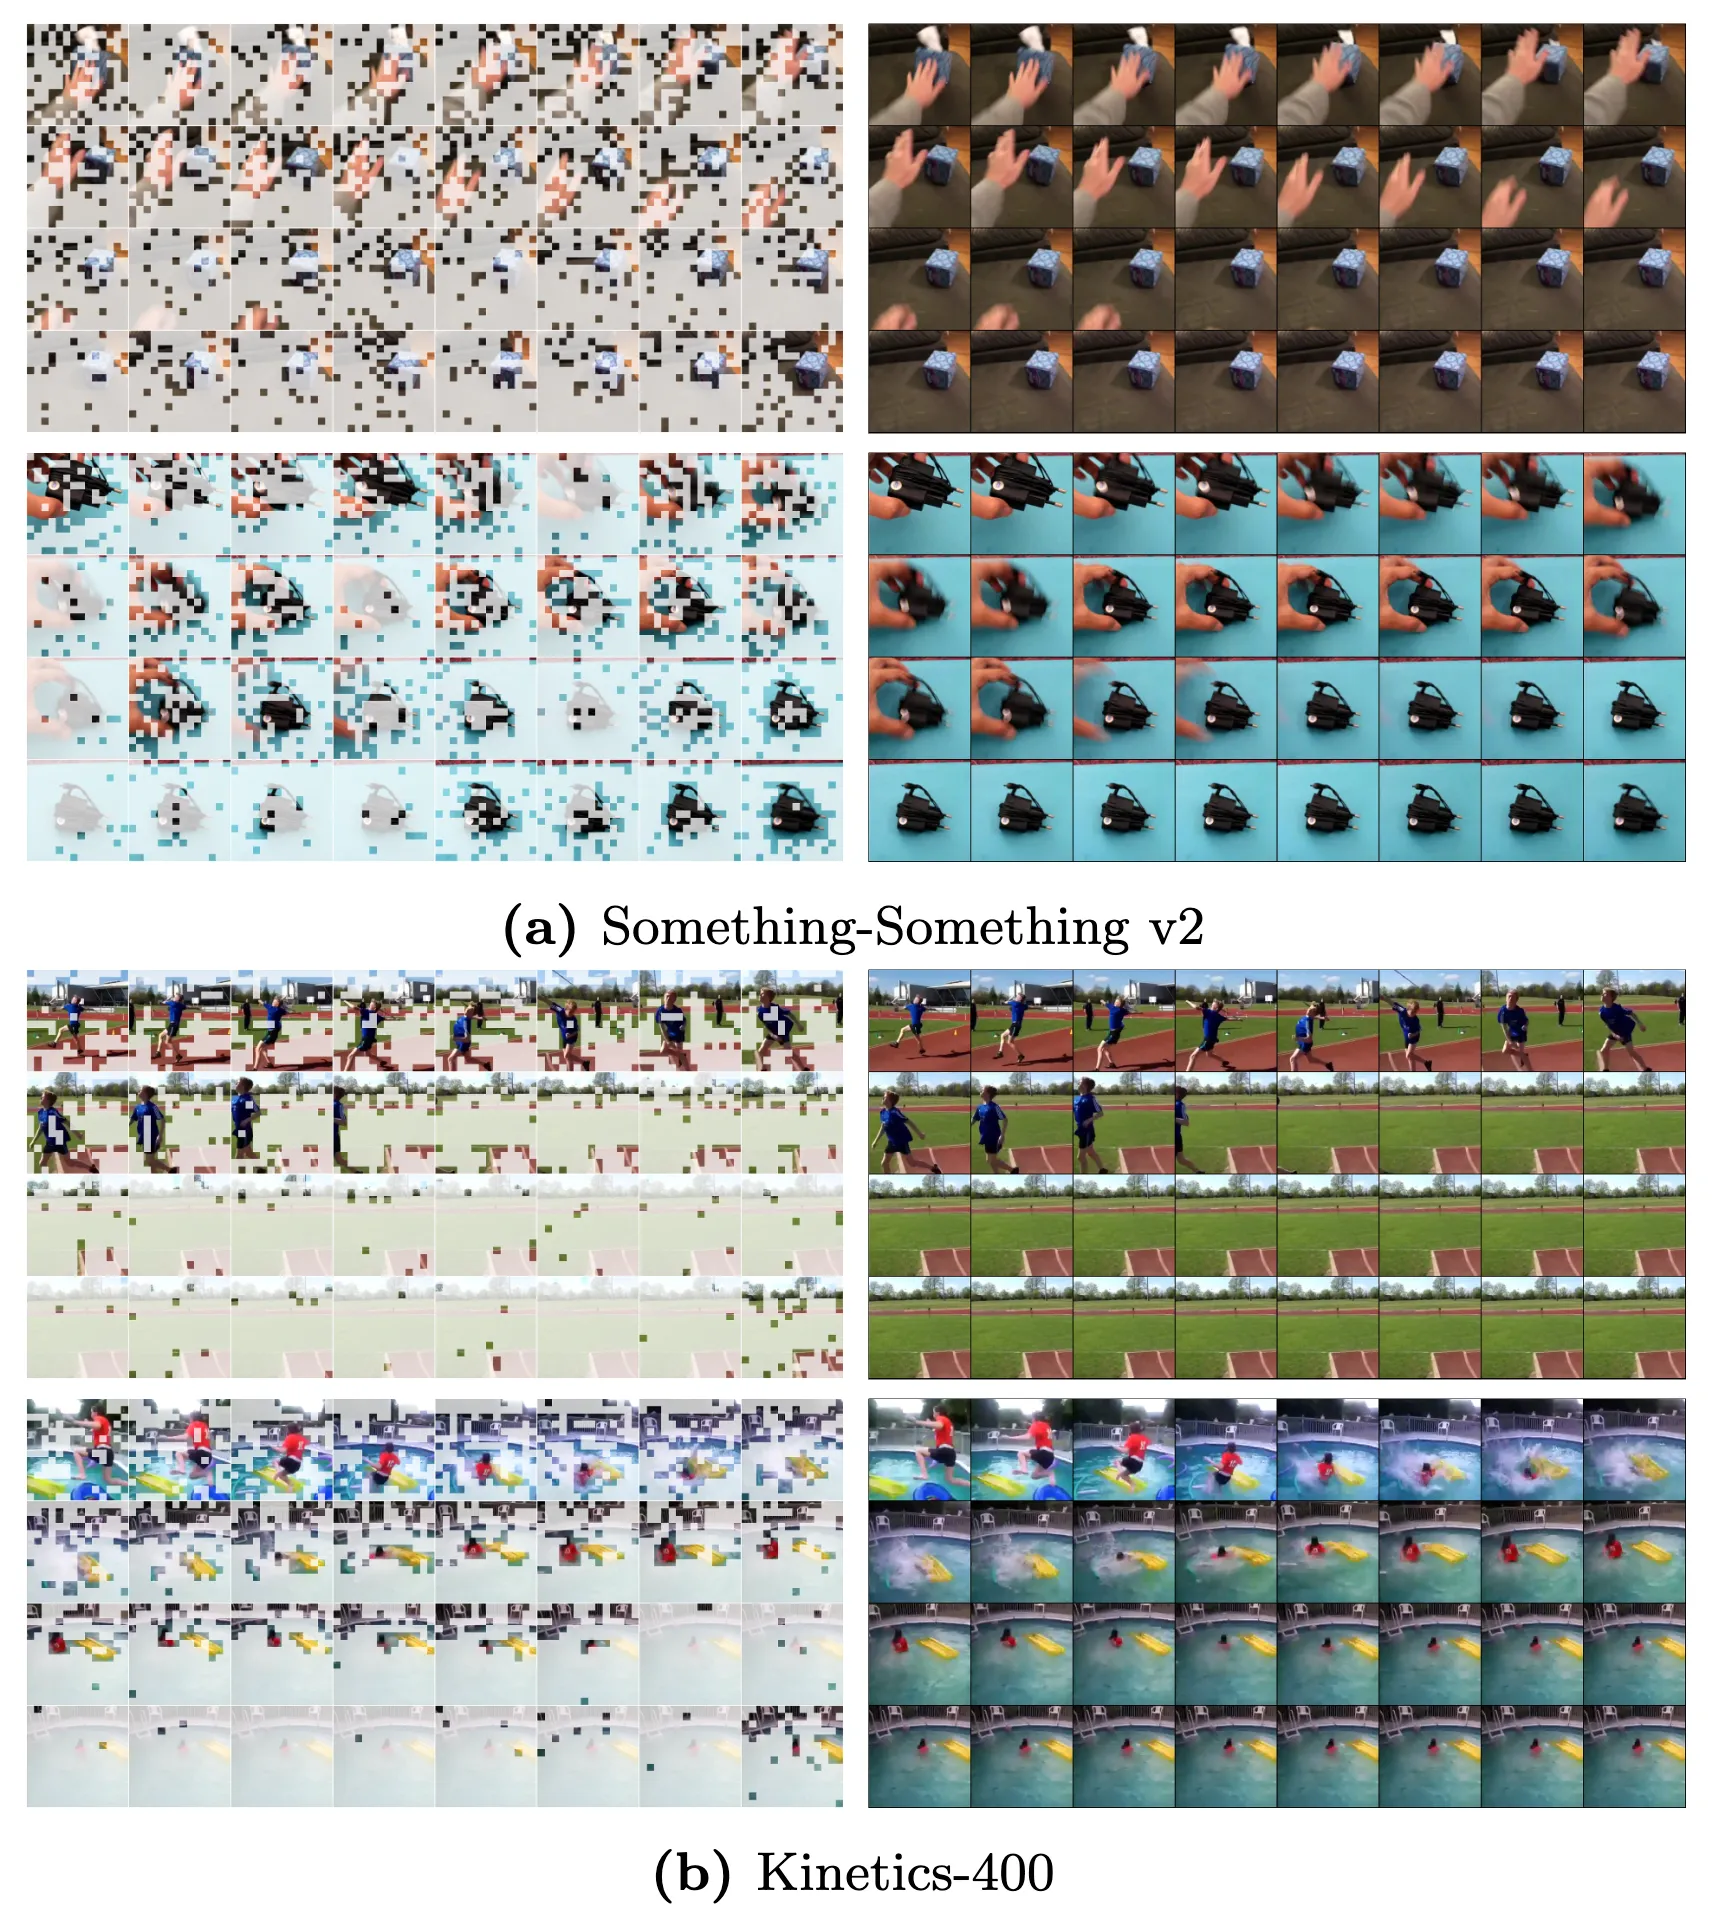
- 实验与证据: 同计算量下, 准确率大致都呈现 K-centered 方法 > Random 方法 > Full frame 方法
- 我的思考:
- 核心特征是使用非机器学习算法,在将视觉信息输入深度网络之前进行 pruning.
- 这篇文章的结果有力支持我们的猜想——将采样方式从时域稀疏的完整帧转变为时域上更稠密的残缺帧,能在相同计算量下提高准确率。
- 这篇工作的 patch 采样是以 clip 为单位跨帧进行的,因此即使画面前后变化不大,每帧采样的 patches 也会有差异,尽可能覆盖更多信息。
- 直接对原始向量(未 embed)计算欧氏距离,是否真的准确合理?加入可学习的 embedding 是否更好?
03 · RetinaViT#
PAPER NOTE · 2024
Retina Vision Transformer (RetinaViT): Introducing Scaled Patches into Vision Transformers
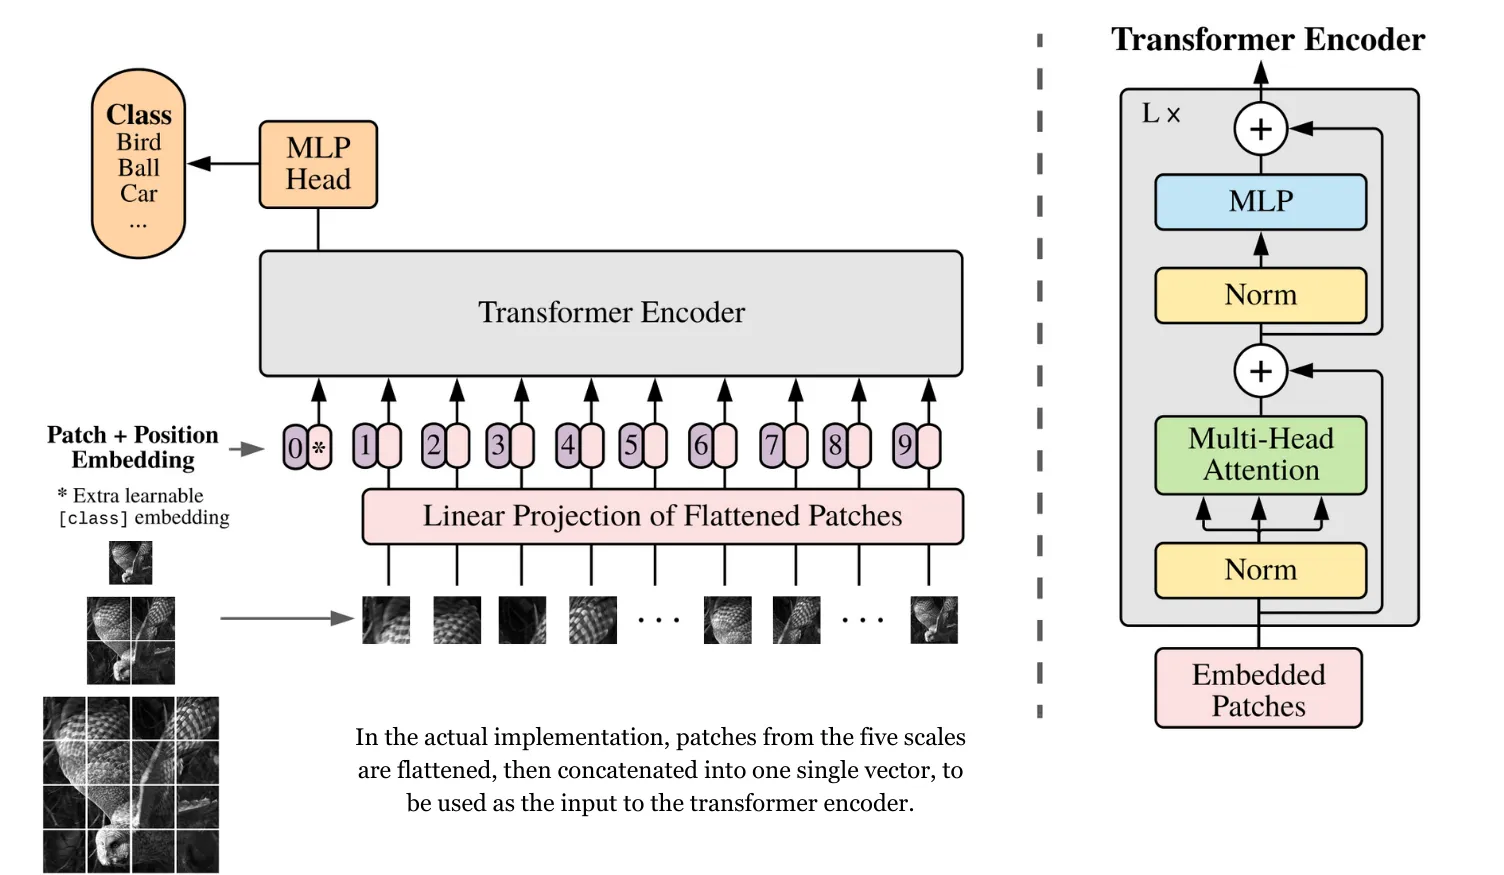
- 问题与动机: 从人类视觉机制出发——人类理解视野,往往是先关注总体画面(低频信息),后关注局部细节(高频信息)。
- 关键机制: 将输入图片缩小到若干尺度,然后以同样的 patch size 切分它们,并使用特殊的位置编码同时编码 patch 的位置和”感受野“大小,一并输入给 ViT.
- 例如,将 224x224 的原始图片缩小为 128x128、64x46、32x32、16x16 等,然后均切分为 16x16 的 patches.
- 位置编码基于
big_vision库中的 2-D sincos 编码。首先,为原始 224x224 图像中的每个 16x16 patch 分配位置编码。对于缩放图像中的 patch,则根据其在原图中对应的感受野,对该区域内各原始 patch 的位置编码按覆盖面积加权平均,再将所得向量的模长放大 倍,其中 为感受野在原图中的边长。这样,位置编码便同时包含了空间位置和感受野尺度信息。
- 实验与证据:
- 引入多尺度 patches 增加了计算开销,但分类准确率的提升较为有限。
- 据作者称,他们观察到模型自发形成了由低频到高频的注意力偏好,在底层更多关注粗 patches,在上层更多关注细 patches.
- 我的思考: 先前已经有很多类似 idea 的工作了,本篇新颖性较弱。我认为,考虑将这种想法迁移到视频理解方向,几个方面还需要进一步探究:
- 能否/如何根据任务选择空间区域和尺度?
- 能否与 GliTr 思路结合,在画面窗口内使用细 patches,外面使用粗 patches?
- 对于视频输入,对不同帧使用不同大小的 patches,以适应帧的信息量和画面冗余?
- 该方法是否真的在固定 computational budget 下提高了性能?
04 · FlashGaze#
PAPER NOTE · 2026
FlashGaze: Training-Free Multi-Scale Patch Pruning for Efficient Video Understanding
从 K-centered 和 RetinaViT 一路调研下来,自然就会产生 FlashGaze 的 idea:
使用非深度学习算法做 patch 级降冗余,减少经过深度网络的数据量;并且使用类似 RetinaViT 的三种缩放,在 K-centered 中的“保留”与“丢弃”之间补充了更多档位来控制信息粒度。方法新颖,效果出色。
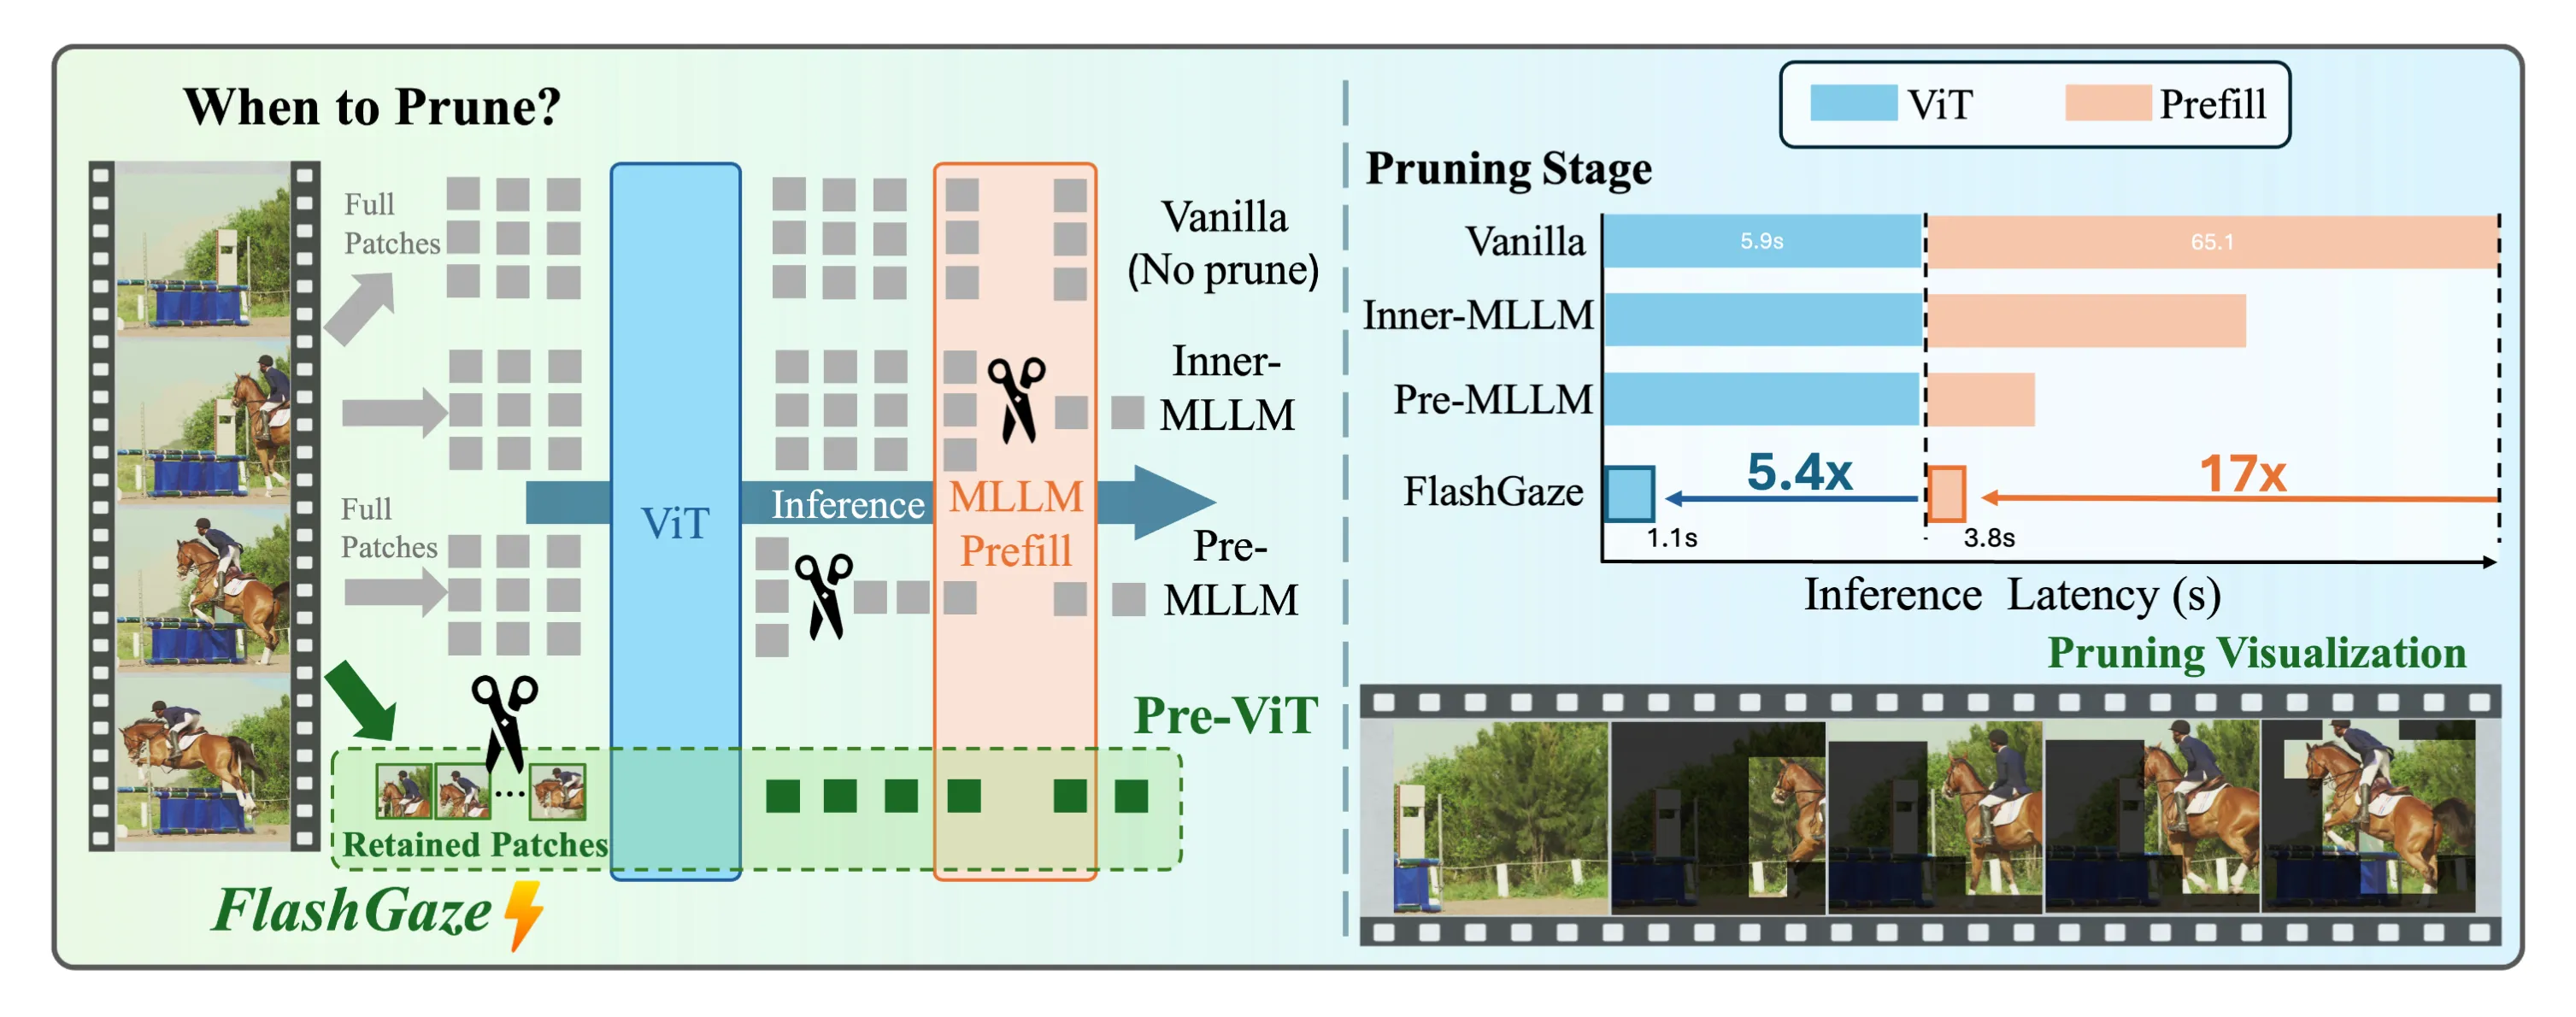
先前的各种压缩或降冗余算法,有的作用在 MLLM 内部,有的在 ViT 和 MLLM 之间,有的在 ViT 之前(本篇采用的方式)
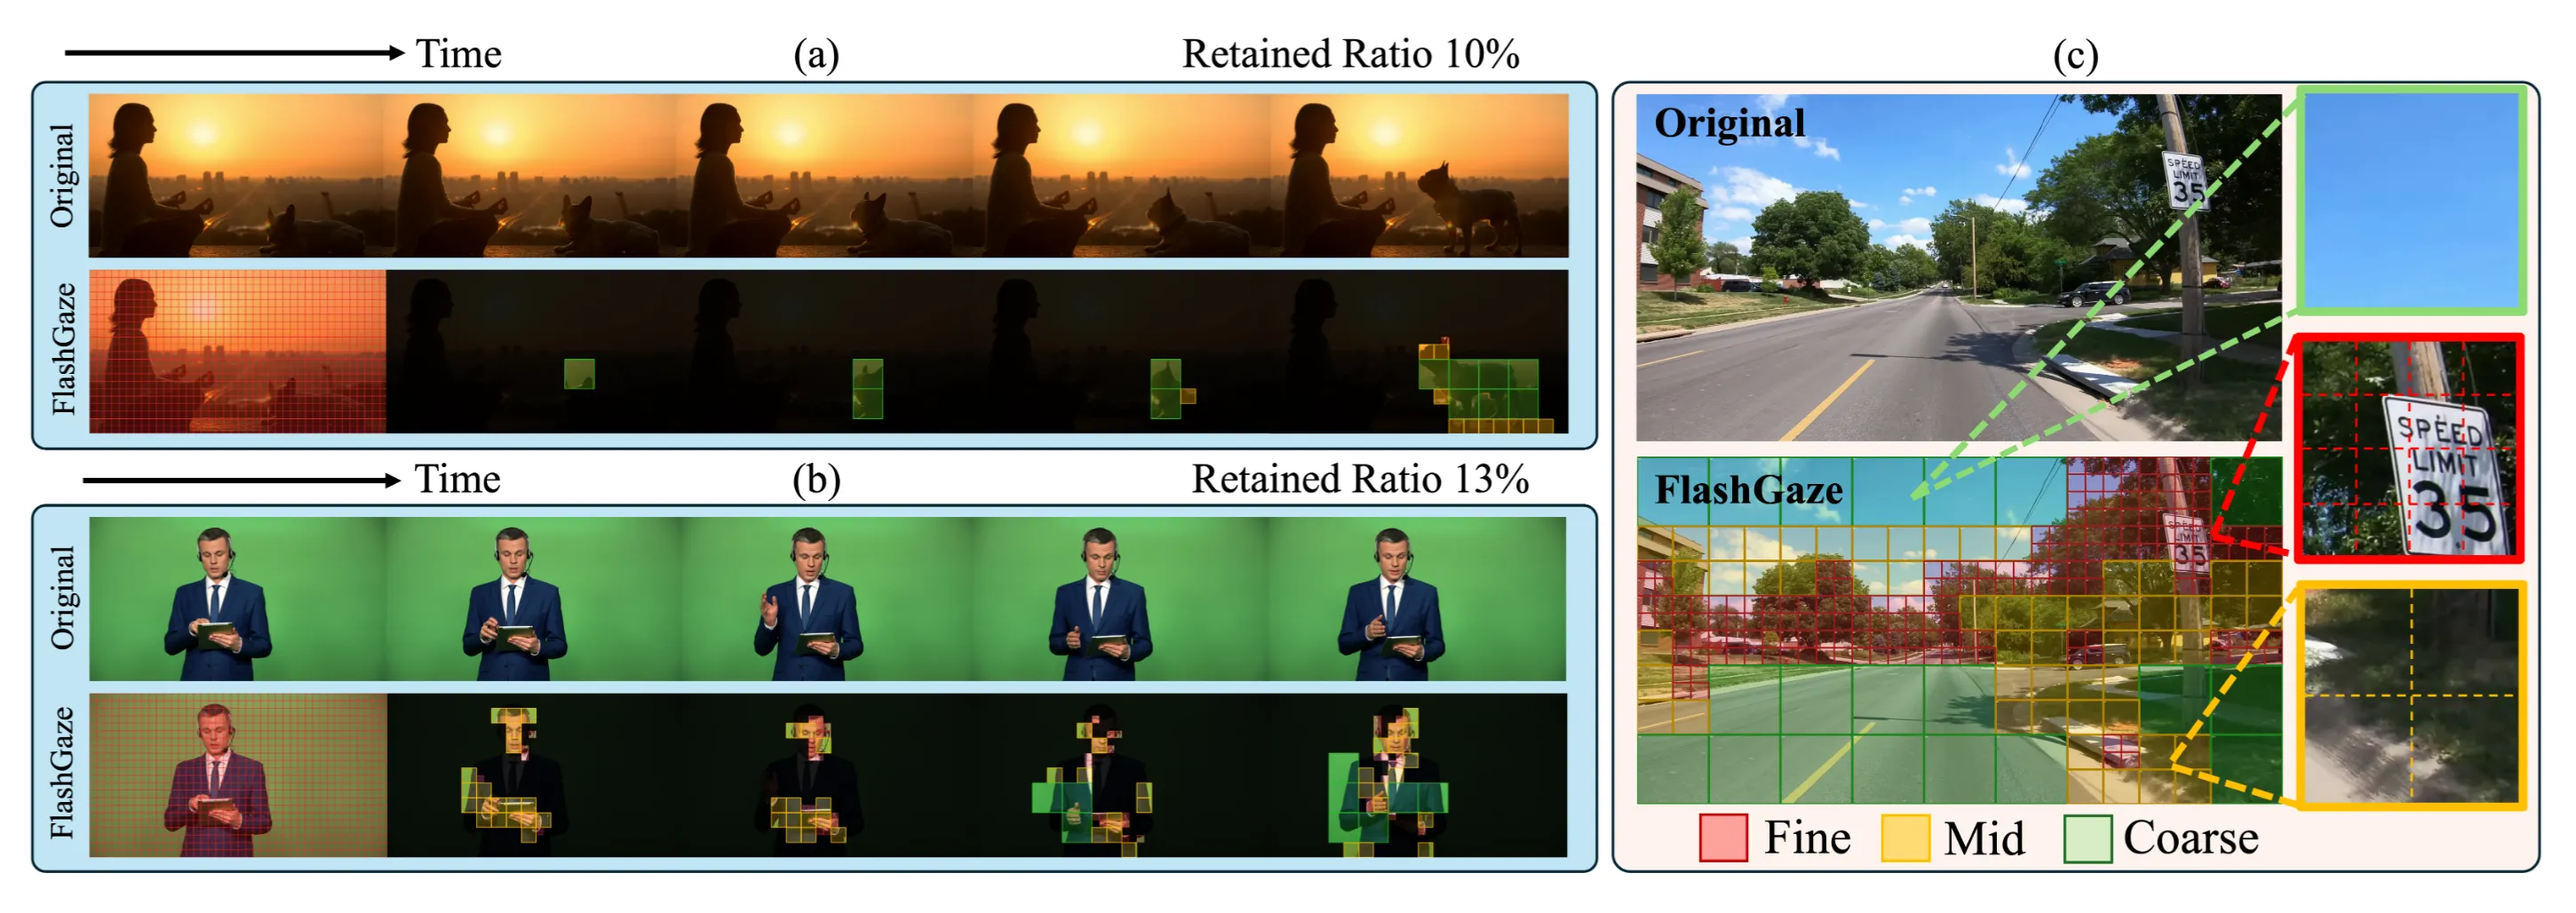
怎么还看到了一丝 DINO 的影子🤗
- 问题与动机: 长时高分辨率视频中的大量时空冗余造成了不必要的计算开销,而现有方法往往剪枝过晚或依赖额外训练,因此本文希望在视觉编码前,以无需训练的方式筛除冗余、保留关键内容,从源头降低视频理解成本。
- 关键机制:
- 将画面切分为 patch(基操),然后尝试去除冗余 patches,或合并信息密度低的 patch.
- 定义了每个 patch 被 drop,merge,keep 的信息损失量(keep 损失为 0)
- 为了降低时域画面冗余,引入了一种记忆机制,保存画面上每个位置上一次被采样时的 patch 内容,然后比较现在此位置的 patch 内容与记忆中的差别,差别越大,drop 的代价越大。
此外,论文加入了局部位移匹配,避免相机的位移被解读成内容变化。 - 为了降低空间画面冗余,每个待 merge 的 patch 会先下采样再上采样,再与原始 patch 比较差别,差别越大,merge 的代价越大。
- 为了降低时域画面冗余,引入了一种记忆机制,保存画面上每个位置上一次被采样时的 patch 内容,然后比较现在此位置的 patch 内容与记忆中的差别,差别越大,drop 的代价越大。
- 三种 merge 尺度(
fine,mid,coarse),每一种的 patch 边长都是前一种的 2 倍,因此较大的 patch 内部包含 4 个较小的。作者使用四叉树 DP 求解:保留特定 patch 总数时,代价最小的方案。
- 实验与证据: 大幅降低推理延迟和显存占用的同时,基本保持视频理解准确率;节省下来的计算资源还能用于增加帧数和分辨率(尽管高帧率和分辨率没有带来准确率的显著提升)。
- 我的思考:
- 值得质疑的假设:像素变化越大,对回答问题越重要吗?对于周期性变化的画面,例如钟摆、水波,反复观看它们意义不大;但是对于人的手势、眼神、表情,微小变化可能包含丰富含义
- Merge 的损失没有考虑历史信息的补充作用。例如,当前 patch 的 merge 损失较大,但是模型可以结合历史 patch 补充损失掉的信息,因此理论上仍可以 merge.
- Memory 只存最后一次的 patch,无法建模更加长程的画面关系