CoderXL's Blog

Back

论文阅读 →

最近在读多模态流式推理相关工作,这些论文旨在解决相近的问题。这是这一系列阅读笔记中的第一篇,主要聚焦于主干工作的增量创新。

01 · StreamingThinker#

PAPER NOTE · 2025

StreamingThinker: Large Language Models Can Think While Reading

Junlong Tong et al.

  • 问题与动机: 传统推理模型需要等待所有 input 输入之后再开始推理,这种串行瓶颈带来了较高延迟,且易削弱模型对较早的输入 token 的注意力。
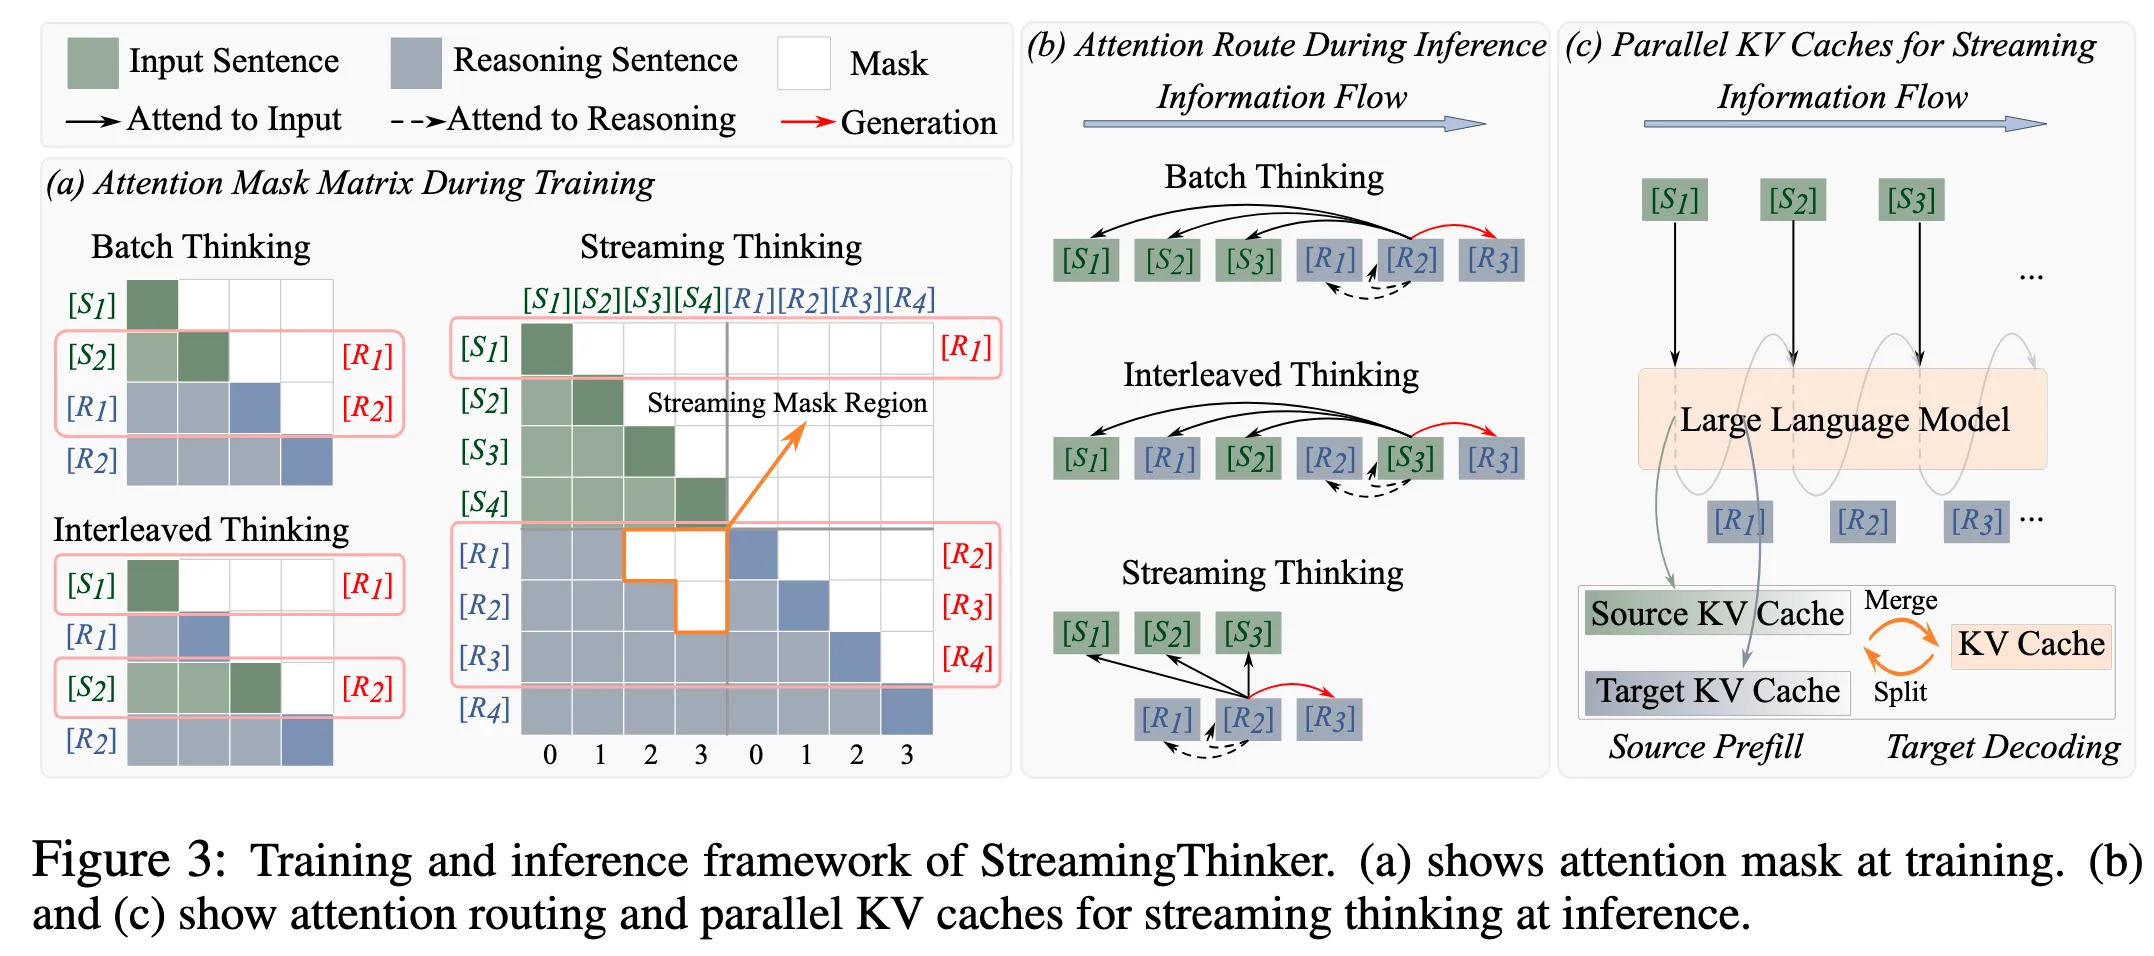
  • 关键机制: 本文使用创新的位置编码(输入和思维链独立从零递增)、因果掩码和 KV Cache(平时输入和推理分开缓存,需要思考时再合并)设计,让模型能够在接收流式输入的同时并行推理,产出思维链,以减少最终输出时的等待时间。
  • 实验与证据: 流式结构能用更少的 token,换取接近传统蒸馏模型的准确率,并在一些情况下超过传统模型。
  • 我的思考: 流式推理的架构,包括掩码设计、位置编码、训练和推理框架的提出,均具有开创性和奠基性,但也存在一些问题有待后续工作解决。

以下是一些疑惑

实验数据构造

为什么 CoT 的构造要先让 32B 小模型跑一遍,再让 235B 大模型调整,而不是直接让 235B 大模型生成?

作者没有标注这样做的原因,但对此可以有一些推测:

  1. 直接通过提示词要求模型逐句推理,容易出现偏离顺序、推理冗长等问题
  2. 两阶段方法能显著减少大模型的输出长度、重试次数,或提高合格率
文中有关输入和推理序列位置对齐声明有误

论文原文:

Furthermore, identical position IDs ensure that, during streaming reasoning, a reasoning sentence is positioned nearest to its associated input sentence and distant from others, which conforms to the essential principle of streaming alignment.

质疑:

SPE 将 Input Stream 和 Reasoning Stream 的 token 分别从 0 连续编号,但对应的 Input Unit 与 Reasoning Unit 长度通常不同。因此,两个序列可能持续累积偏移,不能保证两序列中相关的位置,其位置编码也一定相近。

两序列独立位置编码引入的 Cross-stream Positional Aliasing

论文提出的位置编码方案(SPE)允许 Input Token 与 Reasoning Token 具有完全相同的 position ID,而没有额外添加显式的 Stream Type Embedding. 这就是说,在特定情况下,模型可能完全无法区分一个 token 是外部的输入还是自己的推理输出。

考虑模型即将开启下一轮推理时的两种历史:

情况一:

Input:     今天天气怎么样?<EOS>今天天气似乎是阴天<EOS>
Reasoning: [此前推理]         今天天气似乎是晴天<EOT>
text

情况二:

Input:     今天天气怎么样?<EOS>今天天气似乎是晴天<EOS>
Reasoning: [此前推理]         今天天气似乎是阴天<EOT>
text

假设两种天气描述的 token 数相同,且此前推理与首段输入(含 EOS)等长,使两段天气描述的 position IDs 完全重合。

此时,新一轮推理同时看到的两组内容 token,在交换前后具有完全相同的 (Embedding, Position ID) 集合。由于 Attention 对 Key/Value 的共同排列具有置换不变性,第一层 Attention 无法仅凭这些内容 token 判断哪句话来自 Input,哪句话来自 Reasoning。

虽然 EOS/EOT 可以提供身份线索,但它们位于句尾,受 Causal Mask 限制,无法反向标记前面的内容 token。

02 · Speak While Watching#

PAPER NOTE · 2026

Speak While Watching: Unleashing TRUE Real-Time Video Understanding Capability of Multimodal Large Language Models
Junyan Lin et al.

  • 问题与动机: 多模态任务的输入量往往较大,尤其是涉及视频理解时,因此尝试让模型边接受输入边输出回答。
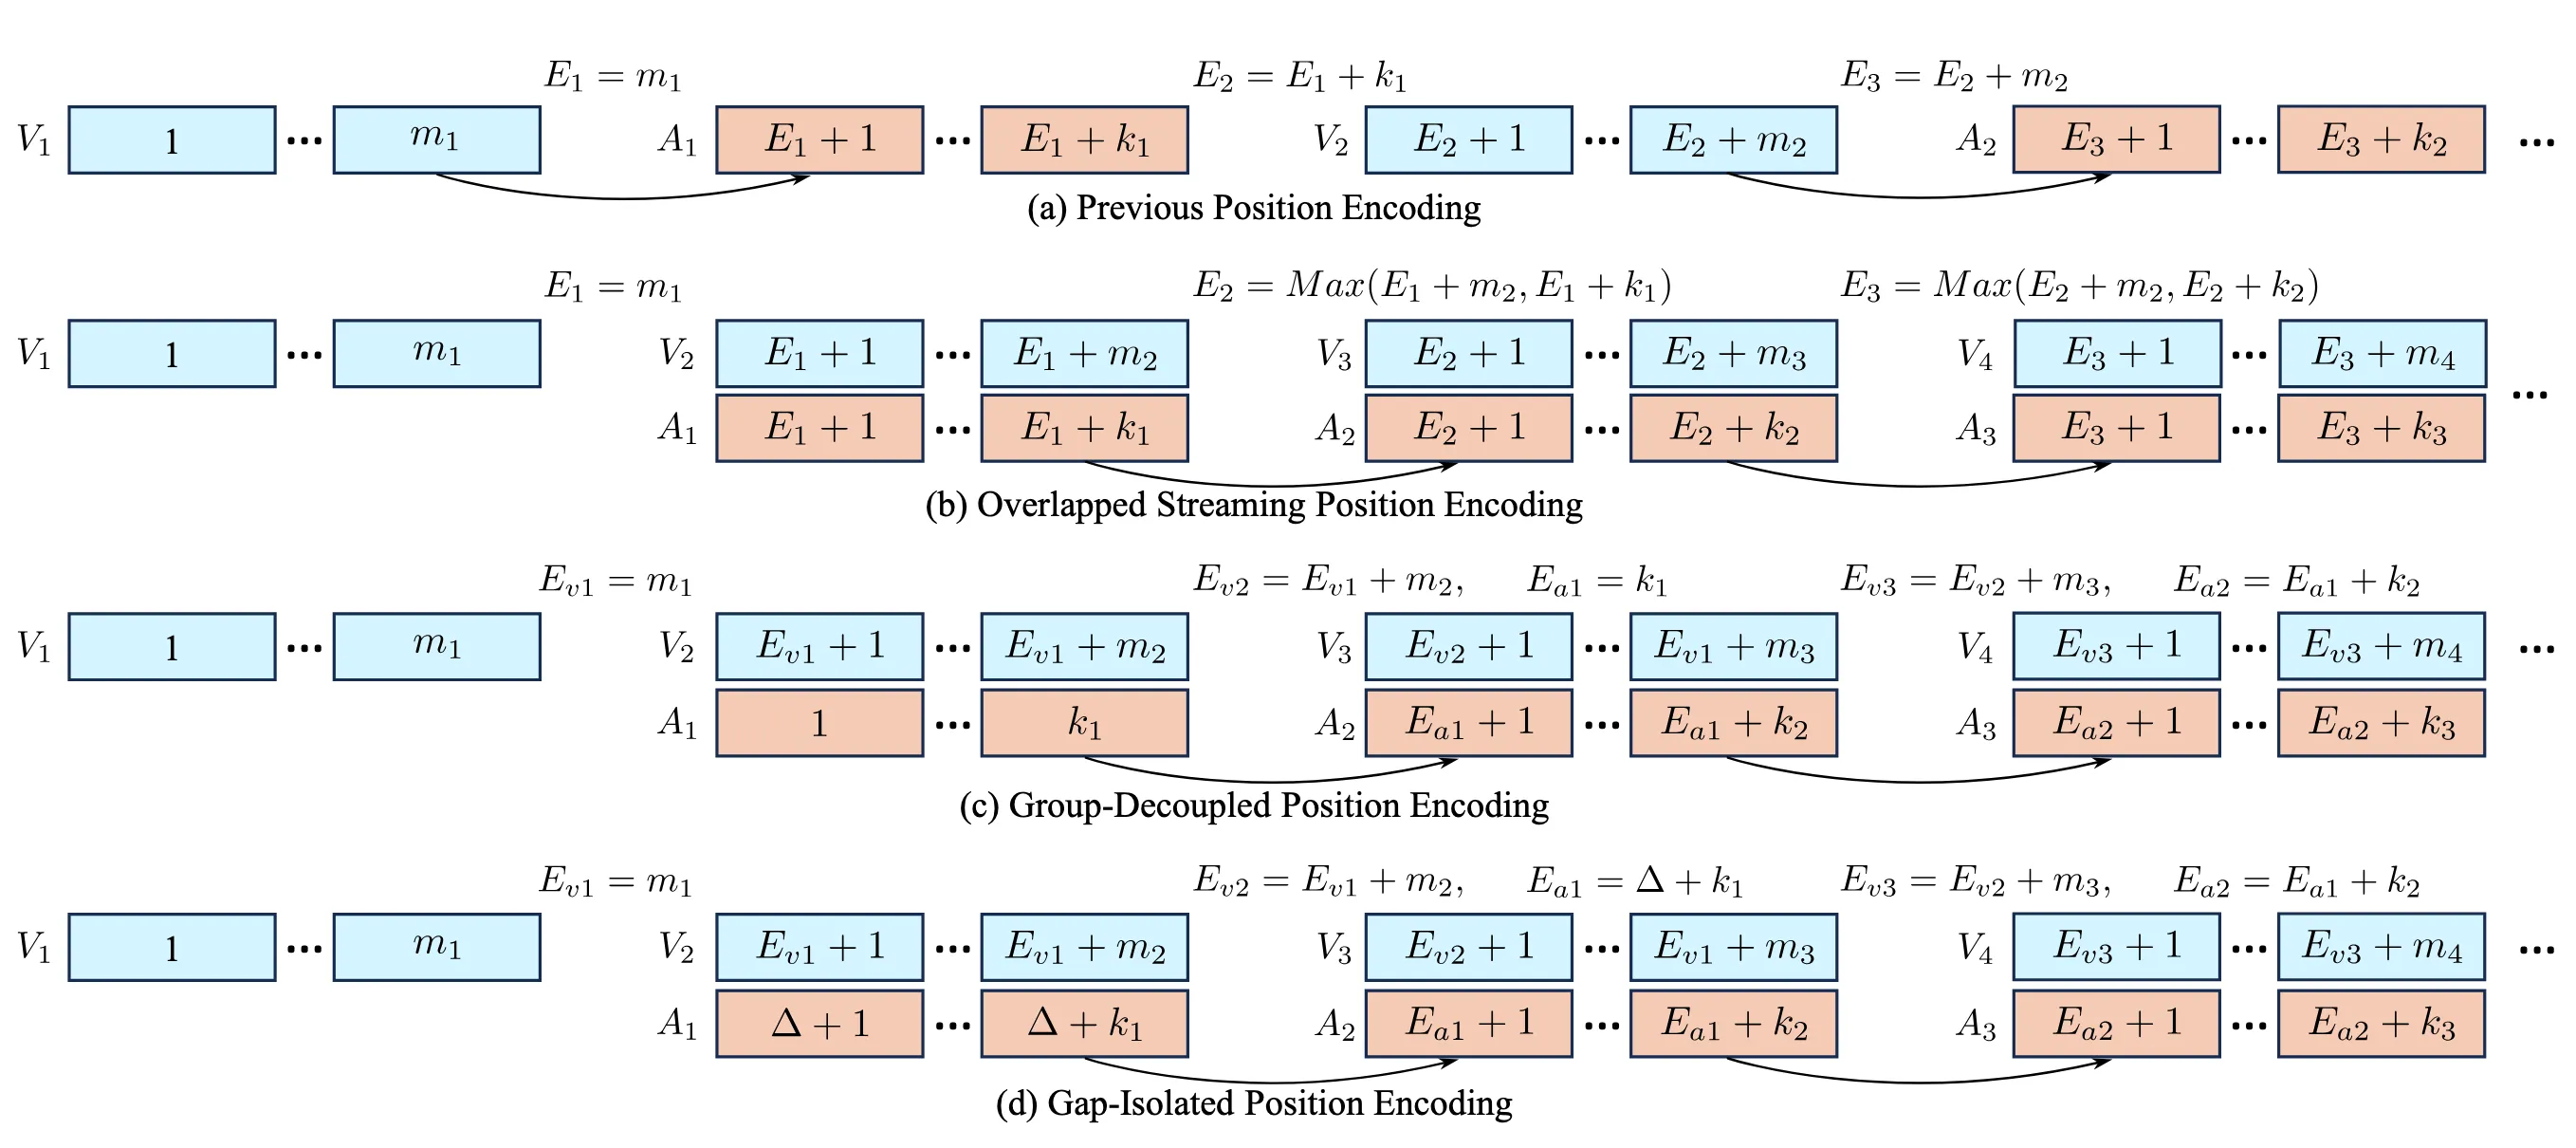
  • 关键机制: 继承了 StreamingThinker 中的「多轨并行」思路,总体仍然在探讨 Batch(Offline), Interleaved, Streaming 的性能差别,但深入探究了在 Streaming 方法中换用多种位置编码方式的性能差异。
  • 实验与证据: 利用 LLM-as-Judge 评价几种方法,最终证明 ST 所采用的方法(GDPE)确实是其中最优秀的,而直觉上顺畅的 OSPE 实际上表现不突出。
  • 我的思考: 其实在阅读 ST 时,就不难感觉到它采用的“独立递增位置编码”有一些潜在问题(已在上文列出)。这篇工作则用多种位置编码方案的对照实验回应了这些问题,并将 ST 的方法推广到了 MLLM 领域,并展望了未来有待进一步研究的方向——开发下游任务特定的并行方式,应用到其余多模态领域或具身智能任务中、针对流式并行化的 GPU 优化。

论文中重点比较的三种 PE 方法

  1. Overlapped Streaming Position Encoding (OSPE):输入和输出序列在每轮开始时都对齐位置,各自递增(因此允许重合),完成后取较长序列末尾的下一位作为下一轮的起始位置。
  2. Group-Decoupled Position Encoding (GDPE):和 ST 中的方式相同,输入和输出各自从零递增,允许重合。
  3. Gap-Isolated Position Encoding (GIPE):类似 GDPE,但是给输出序列的起始位置加一个固定的大偏移 Δ\Delta,以期能够避免位置编码重合,同时辅助模型区分两个序列。
一个有趣的想法

仔细思考一下位置编码中的“正交”和“独立”。

在 Qwen2.5-VL 中,如果只考虑视频模态,则位置编码涉及三个 正交 的维度,即视频帧的长宽和时间戳。这三个维度可以线性组合,组合出的空间是稠密的(几乎各种组合都会被用到)。这种情况下,Qwen2.5-VL 选择了在 RoPE 基础上进行修改得到 MRoPE.它相当于把参与旋转的通道对分成三组,分别使用 t,h,w 作为位置参数进行旋转,然后再将三部分重新 Concat 到一起。这就好像说,把原版 RoPE 中耦合的通道分成了解耦的三部分,可以任意组合。

那么为什么本工作不使用这种位置编码呢?因为输入和输出虽然可以拆分成 独立 的,但却不是正交的——它们仍在同一方向上延伸。这种情况下,我们希望它们之间还可以保留一些位置偏序关系,而不是互相完全不关心相对位置。此外,如果按照 MRoPE 的思路编码,位置空间将会十分稀疏,浪费 latent dimensions.

其他可以考虑的位置编码方案
  1. 奇偶交错位置编码:让输入输出分别占据奇偶位置
    这种方案同时具备 GDPE 的独立递增和 GIPE 的编码不重合性,但是引入两个新的 side effects:同一序列内的编码间隔乘以 2,且不同序列的编码是紧挨着的。要让这种方式可行,必须证明 RoPE 可以严格分辨奇偶性这种细粒度位置差异。
    此外,出现在 Interleave 中的退化问题会在这种编码方式下重现吗?个人认为不会。因为 Interleave 实际上导致文本 Token 之间的间隔可变,加大了 attend 定位的难度,且文本可能被插入的大量视觉信息冲淡;而我们的奇偶方法保持了文本 Token 之间的间隔。
  2. 间隔交错位置编码:进一步结合「奇偶交错位置编码」和 GIPE,可以让两序列分别占据区间 [20n,20n+10)[20n, 20n+10) 和 [20n+10,20n+20)[20n+10, 20n+20).

03 · Think-as-You-See#

PAPER NOTE · 2026

Think-as-You-See: Streaming Chain-of-Thought Reasoning for Large Vision-Language Models

Jialiang Zhang et al.

  • 问题与动机: SWW 探索了 VLM 的流式输出,而 TaYS 则按照 ST 中的方式构建了 VLM 的流式推理。
  • 贡献: 增量较少,主要在于将 VideoEspresso 数据集中的视频组织成与视觉时间对应的中间推理,并且补齐了推理发生时刻和视频事件时刻的对应验证实验;其余诸如掩码、位置编码、Kv Cache 仍然沿用前两篇。
一些质疑

TaYS 中数据集的构造和监督微调方式似乎有一些潜在问题:

  • 生成流程及上下文可见性不够明确。 正文描述为让 GPT-4o 生成逐帧的 (Qt,Rt,At)(Q_t, R_t, A_t) 三元组,但附录 Figure 10 展示的是结合问题、最终答案和原始 evidence,批量改写逐帧描述的提示。故生成时 GPT-4o 上下文可见性不明确:
    • 如果生成时只能依据当前帧 evidence,则监督标签中可能缺少显式的跨帧状态比较与证据整合,导致微调后模型的帧间推理能力不足
    • 如果生成时可访问完整 evidence 或最终答案,则可能将未来才能确认的信息提前写入当前推理,形成不符合流式因果约束的监督
    所以更好的解决方式是按时间前缀提供证据及历史推理,避免提供会泄漏后续信息的答案内容;或者明确提示 GPT-4o 生成每个三元组时只能依赖前向信息。
  • 相似度去重可能损失关键状态变化。 附录中的 Algorithm 1 的筛选机制基于相似度,可能把表达关键细微差别的两个描述当做重复筛掉。
  • 监督目标未明确保证跨帧推理。 因此,模型可能仅仅通过生成按时间排列的帧描述来拟合部分监督,而不必进行真正的跨帧推理。

此外,必须吐槽一下这三篇论文小笔误不少,符号体系也混乱。就比如说这里:

原始论文 P4:

Frame ID Alignment. To ensure strict temporal alignment between visual inputs and reasoning units, we adopt timestamp-based resampling instead of uniform frame sampling. All videos are resampled to 2 FPS. For each target sampling timestamp τt′′=0.5(t′−1)\tau'_{t'} = 0.5(t'-1) seconds, the selected frame Ft′F_{t'} is defined as:

Ft′={Fk,if τt′′∈[τkstart ,τkend ]&Fk is a keyframe,arg⁡min⁡Ft∣τt−0.5(t′−1)∣,otherwise.F_{t^{\prime}}= \begin{cases} F_{k}, & \text{if } \tau_{t^{\prime}}^{\prime} \in\left[\tau_{k}^{\text {start }}, \tau_{k}^{\text {end }}\right] \& F_{k} \text{ is a keyframe,} \\ \arg \min _{F_{t}}\left|\tau_{t}-0.5\left(t^{\prime}-1\right)\right|, & \text{otherwise.} \end{cases}

留意一下可以发现,F□F_\Box 的语义十分混乱,一会儿表示原视频序列中的第 □\Box 帧,一会儿表示采样序列中的第 □\Box 帧。相比之下,τ\tau 和 τ′\tau' 的语义区分就好一些。

如果换我来写,我会用 FtF_t 表示第 tt 个原始帧,F~n\tilde{F}_n 表示第 nn 个重采样帧,τt\tau_t 表示第 tt 个原始帧的时间戳,τ~n=0.5(n−1)\tilde{\tau}_n = 0.5(n-1) 表示第 nn 个重采样帧对应的采样时刻,然后组织成:

F~n={Fk,if τ~n falls in the window of key frame Fk,Ft∗(n),otherwise.\tilde{F}_n = \begin{cases} F_k, & \text{if $\tilde{\tau}_n$ falls in the window of key frame $F_k$,}\\ F_{t^*(n)}, & \text{otherwise.} \end{cases}

其中 t∗(n)=arg⁡min⁡t∣τt−τ~n∣t^*(n) = \arg \min_t \lvert \tau_t - \tilde{\tau}_n \rvert;关键帧的 window 另行定义。

04 · Think While Watching#

PAPER NOTE · 2026

Think While Watching: Online Streaming Segment-Level Memory for Multi-Turn Video Reasoning in Multimodal Large Language Models

Lu Wang et al.

和 TaYS 的出发点基本相同,提出的方法有部分重合,但也有明显差别。

  • 关键机制: 提出了针对 online memory note 的 3 阶段训练流程:
    1. 学习输出段级别的 memory note 并回答单轮提问
    2. 加入多轮对话
    3. 针对性训练模型的长程性能,如长程证据召回、不确定性处理和干扰片段学习
  • 实验与证据:
    • 在无 SFT 时,将 baseline 直接应用到多轮 QA interleaved online,效果相较 baseline 的 offline batch 模式显著下降,体现了流式多轮对话的困难性
    • 在经过 3 stages 的 SFT 之后,TWW 在单轮 QA 的准确性上超过了 baseline 的 offline batch 模式,说明 SFT 和 memory note 共同作用提升了模型性能
    • 相较于只经过了前 2 个 stages 的 TWW,经过了 3 个 stages 的 TWW 在单轮 QA 上有性能提升,说明长视频训练有助于性能提升;且观察其注意力分布,发现 stage 3 的 TWW 会分配更多注意力到更早的 token
    • 经过了 3 个 stages 的 TWW 在多轮 QA 任务上,能力与 baseline 的 offline batch 接近,但输出 token 数大幅减少
    • 随机 mask 掉历史 visual input,让模型仅仅依靠 memory note,则性能随 mask 比例升高而先微微下降后显著降低,显著降低后的水平接近于「无 visual 历史仅依靠 memory note 的水平」
    • 降低视频采样粒度,能减少平均 token 消耗,但带来显著性能降低;提高采样粒度,则性能提升不明显但 token 消耗显著增加
  • 我的思考: 实验没有排除 SFT 对于模型性能的影响,因此不能将性能优势全部归因于 memory bank 机制

此外,MRoPE 递增 position 的方式也值得注意,它通常有三个维度。对于视频 token,它们代表长宽和时间;对于文本 token,三个维度被赋予相同的值,都代表文本序列中的位置。

当连接视频 token 和文本 token 时,递增的规则是把文本 token 的位置设置为视频 token 三个维度的位置的最大值(而不是和)的后一位。

形式化地,就是

Δ[Ru]={max⁡{Tu,Hu,Wu},Ru are visual tokens,L[Ru],Ru are text tokens.\Delta\left[R_{u}\right]= \begin{cases} \max \left\{T_{u}, H_{u}, W_{u}\right\}, & R_{u} \text{ are visual tokens,} \\ L\left[R_{u}\right], & R_{u} \text{ are text tokens.} \end{cases}

其中 RuR_u 表示连续的一段同类型 token,T,H,WT, H, W 分别代表这段视觉 token 所占据的时间、高度、宽度,L[⋅]L\left[\cdot\right] 表示这段文本 token 所占据的长度。Δ[⋅]\Delta\left[\cdot\right] 表示这段 token 实际的 position 增量。

奇怪的一点

Table 6 中 Interleaved 和 TWW 的 TTFT 均为 2304.28,这要么是笔误,要么暗示二者的实验在此处被合并在一起运行了。具体原因尚不清楚。

Comment seems to stuck. Try to refresh?✨