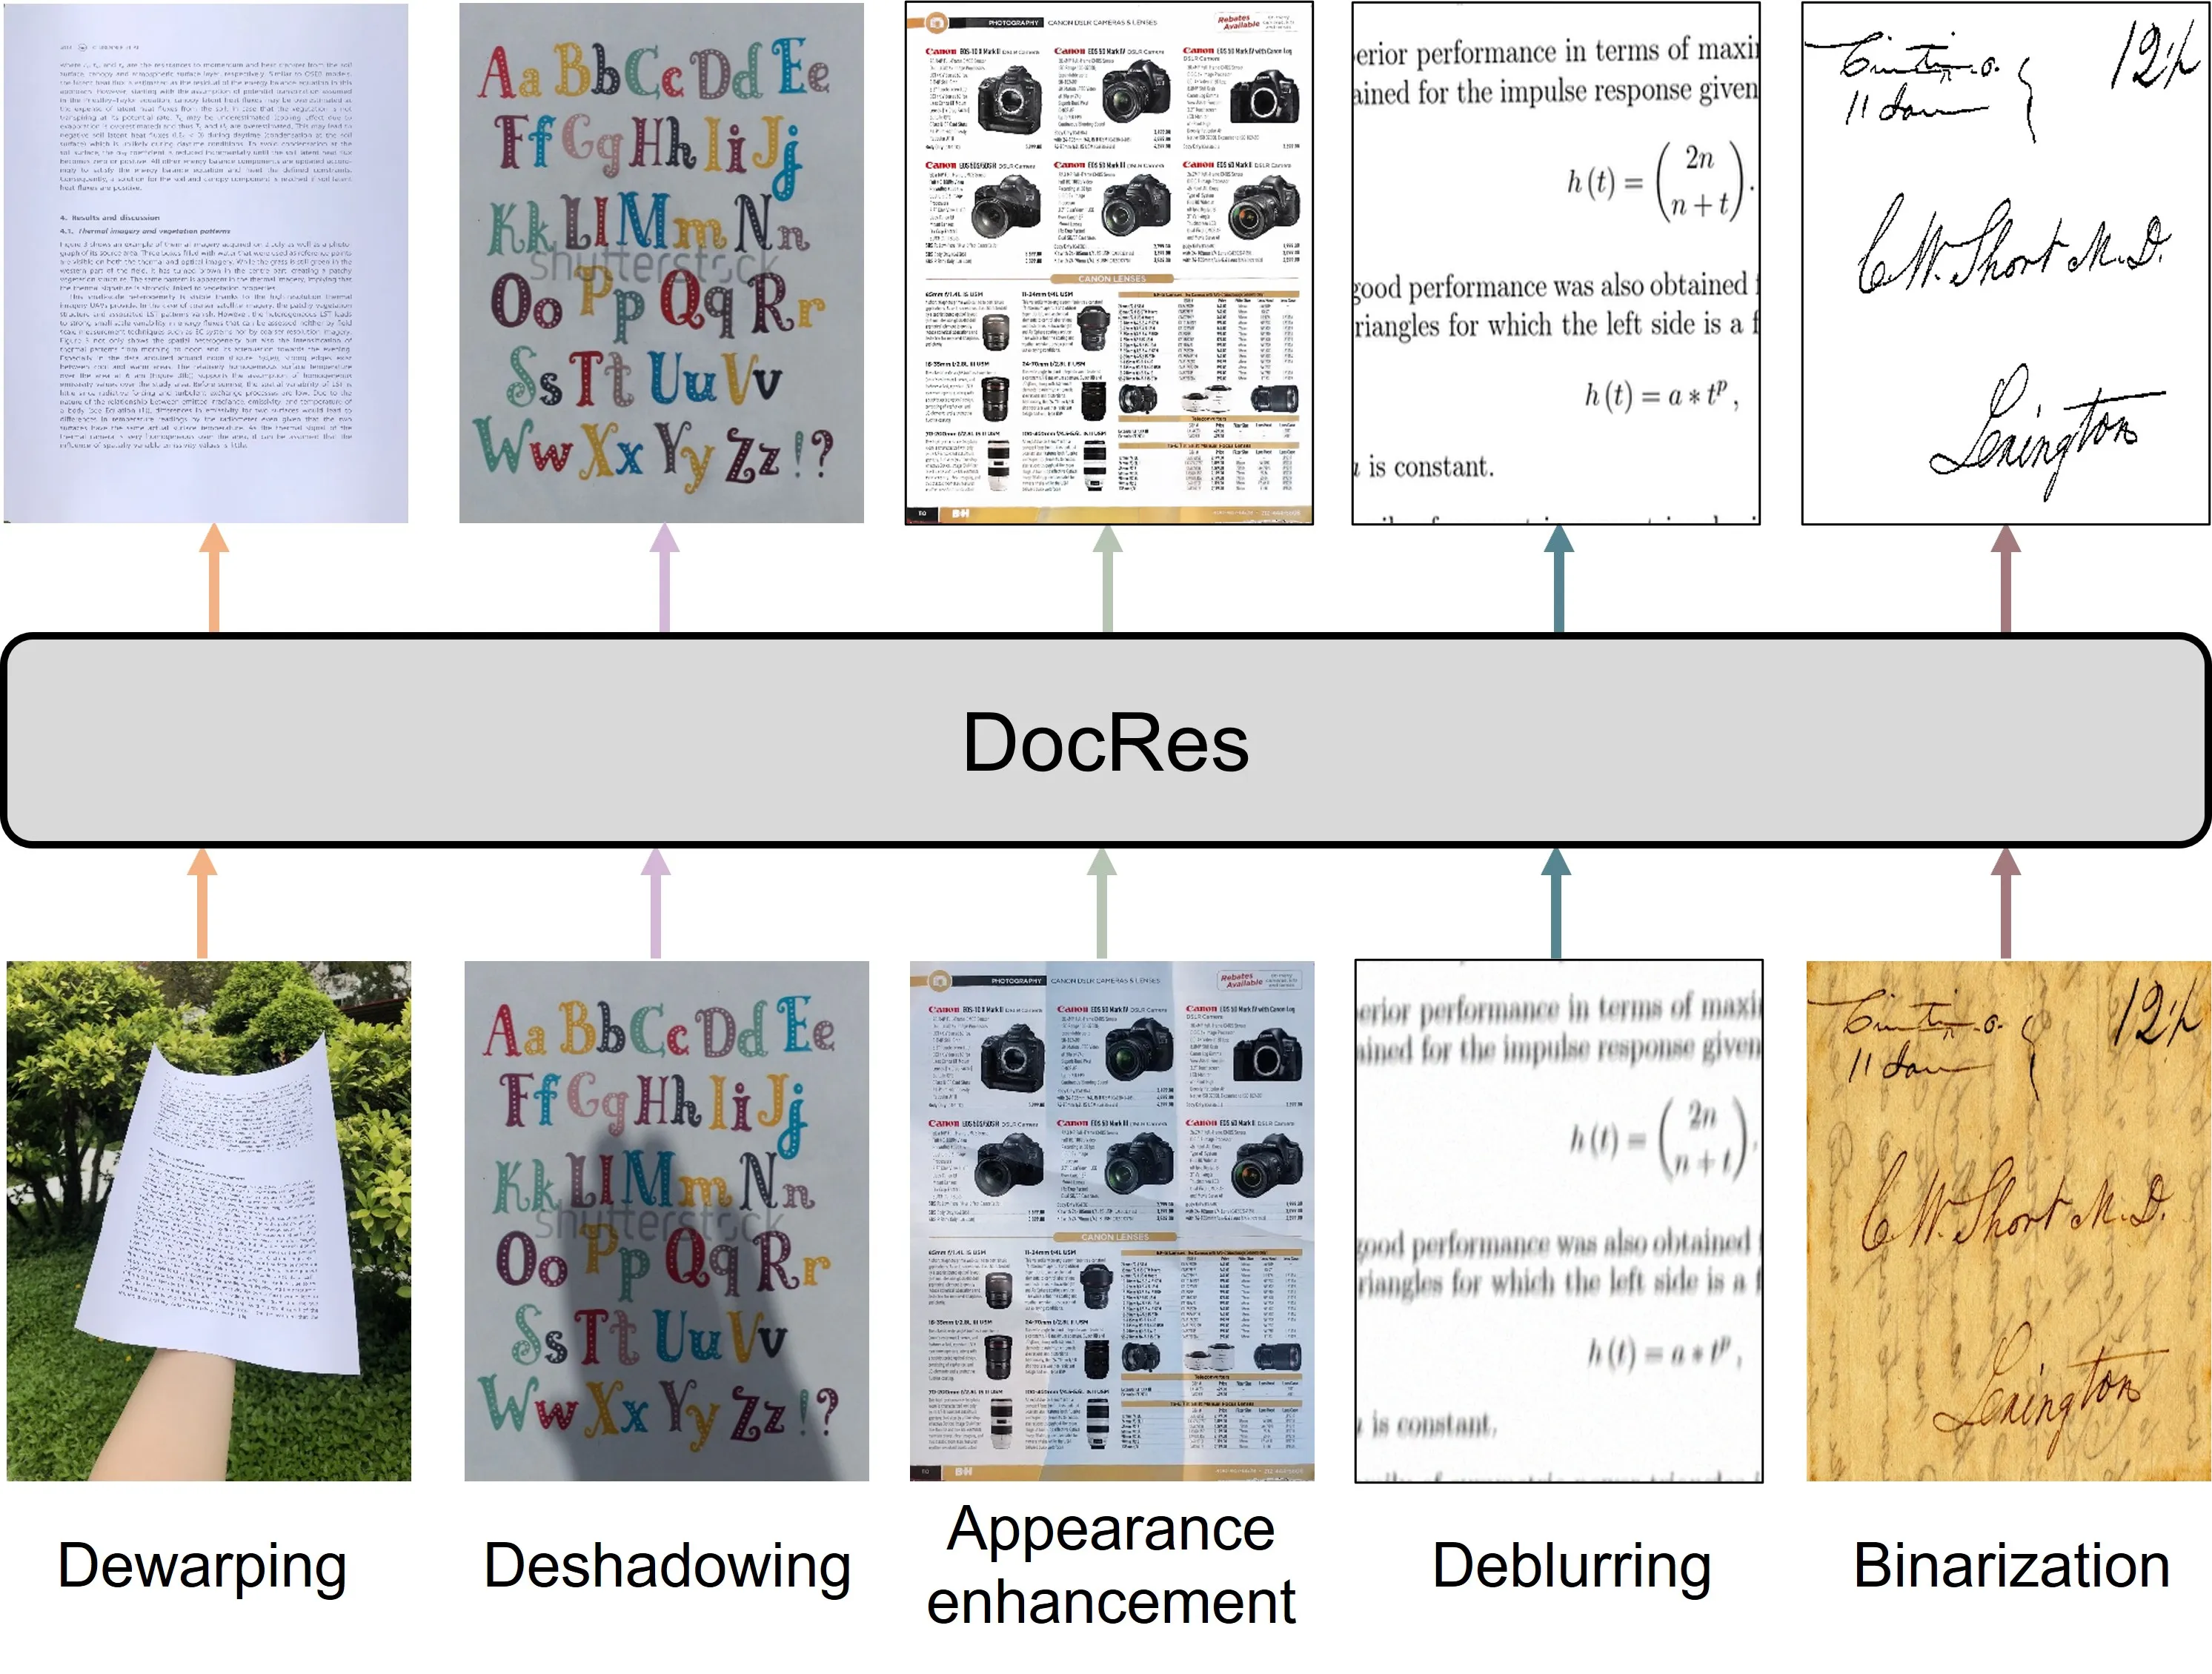
DocRes
DTSPrompt 的两个动机:unify 模型 + 稠密任务提示
原工作#
主要贡献:在文档照片修复领域,探索了对输入进行预处理生成动态 Prompting(DTSPrompt),再输入到主干修复模型的方法。DocRes 与各个任务特化的模型具有竞争力,在特定任务上展现出更强泛化能力和更高性能。
DTSPrompt 会同时结合需要进行的任务和当前输入的图像进行生成,而非仅仅描述任务,或者仅对图像进行 task-agnostic 的预处理。
整体基于 Restormer,是当时图像修复领域的 SOTA backbone. 但 DocRes 被设计为不依赖基座架构的,因此可以切换为其他 backbone.
所有任务均使用一个 unified 的模型,但各任务的 DTSPrompt 的 channel 含义有较大差别,输出的语义也有很大区别。这十分考验模型从 DTSPrompt 的不同分布中猜出任务的能力,且在一些情况下可能导致任务混淆;此外不同任务的输出分布差异,也会提升训练难度,或者导致输出精度下降。
比如:
在 Dewraping 任务中,模型接受掩码后的文档图像、掩码本身、x 和 y 的坐标图;需要输出两个通道的形变图。
但在 Deblurring 任务中,输入的通道变成原图 BGR 和重复三遍的梯度图;需要输出去模糊后的图像。
与其他任务不同,Dewrap 任务不直接回归修复后的图像,而是回归一个形变位移矩阵。
- 一方面是因为模型输出的分辨率较低,需要经过上采样扩大至原图分辨率。回归形变位移矩阵,则后续更容易插值;直接回归图像,则后续上采样难以保证图像清晰度。
- 另一方面是 Restormer 采取的 MDTA 不善于远程高精度地移动 token,而主要擅长基于邻域 token,结合一些全局泛特征做出决策输出。
此外,Dewrap 任务仅仅用到输出 channels 中的前两个,第三个 channel 的输出会被丢弃。
复现#
原工作在 CUDA device 上进行,复现转到了 mps backend.
复现实验 repo 可见 DocRes-Reproduction-and-Tweak ↗.
思考#
虽然 DTSPrompt 没有显式地给模型一个任务提示,只能让模型“猜出” DTSPrompt 和任务之间的联系:在特定情况下,或许会造成任务混淆。
但是在大多数情况下,DTSPrompt 的任务区分度仍足够大,此时其另一个优势会体现出来:
其 token 数量相比传统任务标识 token(单个或少量几个)大得多,模型得以被反复提示任务目标,增强模型的 controllability;传统任务标识 token 可能被大量高清图片 token 淹没, 注意力被稀释,从而更容易导致任务混淆.
原作者还测试了 Fixed Prompt,总体仍有竞争力,但是在 dewarping 和 binarization 任务上较弱,推测是因为这两个任务的输出与其他任务区别明显,需要更强的引导和注意力提示。