课程笔记 →
值迭代和策略迭代都是求解 BOE 的具体迭代算法。二者理论上都能收敛到 v∗ 和 π∗,但是侧重点不同,计算开销、收敛速度不同。
前情提要#
在 3.贝尔曼最优公式 中已经涉及了迭代求解 v∗ 的算法,这个算法准确来讲有两个步骤:
- Policy Update:求解 Greedy Optimal Policy
πk+1=argπmax(rπ+γPπvk)
- Value Update:迭代 pseudo state value
vk+1=rπk+1+γPπk+1vk
初始时 v0 随机取值,交替循环上述两步,可以迭代出 v∗ 和 π∗.
在任何中间步骤,vk 都不能严格称为 state value,因为其不一定满足 Bellman Equation vk=rπk+γPπkvk. 在本笔记中,称 vk 为 pseudo state value.
这个算法就叫做「值迭代」(value iteration)。
此外,我们还会介绍策略迭代(policy iteration)和截断策略迭代(truncated policy iteration)。
值迭代#
分别推导值迭代的两步:Policy Update 和 Value Update.
使用 Matrix-Vector Form 便于理论分析,使用 Element-wise Form 便于代码实现。
下面主要使用后者进行分析。
Policy Update#
正如 Solution 中所说,策略是 state-wise separable 的,因此可以 element-wise 地考虑。
πk+1(s)=argπmaxa∑π(a∣s)(r∑p(r∣s,a)r+γs′∑p(s′∣s,a)vk(s′)), s∈S
设出“action value”:qk(a,s)=∑rp(r∣s,a)r+γ∑s′p(s′∣s,a)vk(s′),这部分是确定的,因此 πk+1(s) 直接 greedy 地以 1 的概率取使 q(a,s) 最大的 a,即:
πk+1(a∣s)={1,0,a=argmaxaqk(s,a),otherwise.
Value Update#
化为 Element-wise form.
vk+1(s)=a∑πk+1(a∣s)qk(s,a)(r∑p(r∣s,a)r+γs′∑p(s′∣s,a)vk(s′)),s∈S
收敛条件设置为 ∥vk+1−vk∥≤ε,其中 ε 是一个预定义的容差。
每一次迭代中,对所有的 (s,a) 对,计算出“action value” q(s,a).
对于 deterministic 的奖励以及状态转移,q(s,a) 的计算是 O(1) 的。
策略迭代#
策略迭代和值迭代最大的不同,就是它的 vk 是准的、是真正对应于当前 policy 的 state value.
策略迭代就是循环进行 Policy Evaluation 和 Policy Improvement,直到收敛。
Policy Evaluation#
求解 Bellman Equation:
vk=rπk+γPπkvk
虽然该方程有闭式解,但正如求解贝尔曼公式中所说的,我们一般使用迭代法:
vk(i+1)=rπk+γPπkvk(i)
这样得到的 vk(n) 几乎就是策略 πk 真正的 state value vk.
Policy Improvement#
对于 πk 的 state value vk,尝试用 BOE 的迭代思路来改进策略:
πk+1=argπmaxrπk+γPπkvk
证明
πk+1 优于
πk
这就是要证明,vk+1≥vk.
而 vk+1 和 vk 分别满足这两个 Bellman Equation:
\begin{align*}
v_{k+1} &= r_{\pi_{k+1}} + \gamma \boldsymbol{P}_{\pi_{k+1}} v_{k+1}\\
v_{k} &= r_{\pi_{k}} + \gamma \boldsymbol{P}_{\pi_{k}} v_{k}\end{align*}
又由 $\pi_{k+1} = \arg \max_\pi r_{\pi_k} + \gamma \boldsymbol{P}_{\pi_k} v_k$,可得
r_{\pi_{k+1}} + \gamma \boldsymbol{P}{\pi{k+1}} v_k \ge r_{\pi_k} + \gamma \boldsymbol{P}_{\pi_k} v_k
于是
\begin{aligned}
v_{\pi_{k}}-v_{\pi_{k+1}} & =\left(r_{\pi_{k}}+\gamma P_{\pi_{k}} v_{\pi_{k}}\right)-\left(r_{\pi_{k+1}}+\gamma P_{\pi_{k+1}} v_{\pi_{k+1}}\right) \
& \leq\left(r_{\pi_{k+1}}+\gamma P_{\pi_{k+1}} v_{\pi_{k}}\right)-\left(r_{\pi_{k+1}}+\gamma P_{\pi_{k+1}} v_{\pi_{k+1}}\right) \
& \leq \gamma P_{\pi_{k+1}}\left(v_{\pi_{k}}-v_{\pi_{k+1}}\right) .
\end{aligned}
由 [Proof of Optimality](/blog/courses/math-behind-reinforcement-learning/2026-09-30-3-bellman-optimality-equation/#proof-of-optimality) 中的相同方法,可以证明 $v_{\pi_k} \le v_{\pi_{k+1}}$.
证明
vπk 收敛于
v∗由于 ∀k∈N+,vπk≤vπk+1 且 vπk≤v∗,因此 {vk} 为单调有界数列,设其收敛于 vπ∞,则只需证明 vπ∞=v∗.
为此,构造辅助数列 vk+1=maxπ(rπ+γPπvk)≜f(vk). 这个数列就是 Value Iteration 所产生的数列。
对于 vπ0,可构造 v0 满足 v0≤vπ0. 下面使用数学归纳法:假设 vk≤vπk,有
vπk+1−vk+1=(rπk+1+γPπk+1vπk+1)−πmax(rπ+γPπvk)≥(rπk+1+γPπk+1vπk)−πmax(rπ+γPπvk)=(rπk+1+γPπk+1vπk)−(rπ∗+γPπ∗vk)≥(rπ∗+γPπ∗vπk)−(rπ∗+γPπ∗vk)=γPπ∗(vπk−vk)≥0(vπk+1≥vπk, Pπk+1≥0)(⇐π∗=argπmax(rπ+γPπvk))(⇐πk+1=argπmax(rπ+γPπvπk))这就证明了 vk≤vπk≤v∗, ∀k∈N+. 结合 vk 收敛于 v∗(Proof of Optimality),可知 vπk 也收敛于 v∗,且收敛速度不慢于 vk.
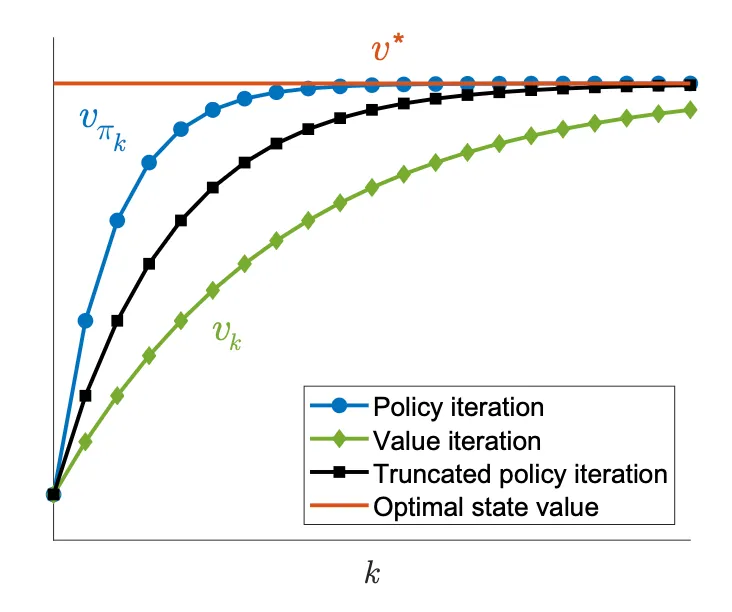
上述证明说明了,策略迭代也可以收敛到最佳策略,且收敛速率快于值迭代。
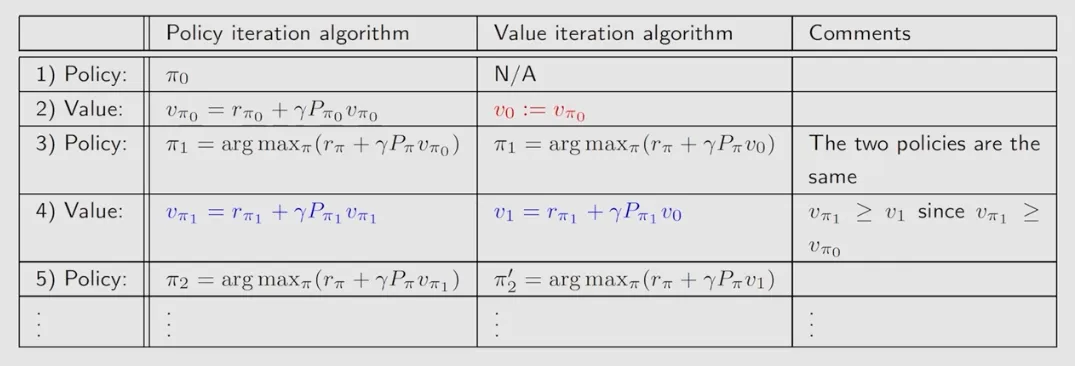
值迭代先始于一个随机“pseudo state value” v0,然后直接用迭代法求解 BOE.
策略迭代始于一个随机策略 π0,然后每次计算准确的 state value vπk,并且基于它优化策略。
二者都有一个 argmaxπ(rπ+γPπvk) 的部分。
可以理解为:值迭代进行一轮 pseudo state value 的计算之后,立刻据此更新策略;而策略迭代每轮会进行多次 pseudo state value 计算,直到收敛到真正的 state value,再据此更新策略。
截断策略迭代#
在值迭代和策略迭代中,都涉及从给定 π 计算 v 的步骤。区别在于,值迭代只从上一步的 vk 计算一次 vk+1=rπ+γPπvk;而策略迭代会一直迭代 vπk+1(i+1)=rπ+γPπvπk+1(i) 直到收敛到 vπk+1=vπk+1(∞).
而截断策略迭代就是二者的折中。它每次计算 vk+1 时,会迭代多次,但是不要求必须收敛。
反过来,也可以说值迭代和策略迭代都是截断策略迭代的特殊情况。
Consider the step of solving vπ1=rπ1+γPπ1vπ1 : vπ1(0) value iteration ←v1⟵vπ1(1)vπ1(2)⋮ truncated policy iteration ←vˉ1⟵vπ1(j)⋮ policy iteration ←vπ1⟵vπ1(∞)=v0=rπ1+γPπ1vπ1(0)=rπ1+γPπ1vπ1(1)=rπ1+γPπ1vπ1(j−1)=rπ1+γPπ1vπ1(∞)
然而,一个问题是,截断策略迭代的最优性怎么由理论保证?虽然值迭代和策略迭代都会收敛,但这并不自动导出截断策略迭代就能收敛。
考虑迭代求解 vπk=rπk+γPπkvπk 的过程:
vπk(i+1)=rπ+γPπvπk(i)下面可以证明,如果初值设置为 vπk(0)=vπk−1,则 vπk(i+1)≥vπk(i), ∀i:
由于 vπk(j)=rπk+γPπkvπk(j−1) 且 vπk(j+1)=rπk+γPπkvπk(j),有
vπk(j+1)−vπk(j)=γPπk(vπk(j)−vπk(j−1))=⋯=γjPπkj(vπk(1)−vπk(0))(∗)而 vπk(0)=vπk−1,这就是说,
vπk(1)=rπk+γPπkvπk(0)=rπk+γPπkvπk−1≥rπk−1+γPπk−1vπk−1=vπk−1=vπk(0)代入 vπk(1)≥vπk(0) 到 (∗) 中,可得 vπk(j+1)≥vπk(j).
三种方法对比#